产棱 · 技术拆解12|高速连接器深度拆解
本文 21 节
- 1. 先给结论:连接器不是带宽的来源,却可能成为带宽的边界
- 2. 为什么NVLink 6会把连接器问题放大?
- 3. 第一层:速度——为什么高速连接器首先面对的是频率问题
- 4. 第二层:阻抗——为什么一个“插头”也要做电磁设计
- 5. 第三层:插损——为什么材料与结构开始变得重要
- 6. 第四层:插损之外,更难的是串扰
- 7. 第五层:为什么“插拔”本身也是一个工程问题
- 8. 第六层:接触可靠性——为什么镀层与端子材料不能忽略
- 9. 第七层:机械结构为什么最终会反过来影响高速信号
- 10. 第八层:热——为什么高带宽系统也会把连接器带入散热问题
- 11. 第九层:为什么连接器必须与PCB一起设计
- 12. 第十层:从单个连接器到整机架,密度才是真正的压力
- 13. 为什么AI高速互联升级,会把价值传导给连接器?
- 14. 连接器产业真正的价值池在哪里?
- 15. 什么情况下连接器会进入“瓶颈池”?
- 16. 一个容易误判的问题:连接器是不是越贵越好?
- 17. 下一阶段:铜互连会不会被光互连替代?
- 18. 产棱如何持续跟踪高速连接器?
- 19. 高速连接器价格 ≠ 高速连接器产业价值
- 20. 最终拆解:真正被AI重新定义的是“连接”
- 附录|关键数据与研究边界
核心问题:为什么AI高速互联升级,会把越来越多的工程压力传导到连接器?
这篇不是连接器产品介绍,而是沿着一条真实高速通道向下拆:速率 → SerDes → PCB → 连接器 → 接触界面 → 机械结构 → 热环境 → 可靠性 → 量产一致性。真正要回答的问题不是“连接器值多少钱”,而是:当NVLink 6把单GPU双向带宽提升到3.6 TB/s之后,物理互连链路里哪些环节开始成为系统上限?
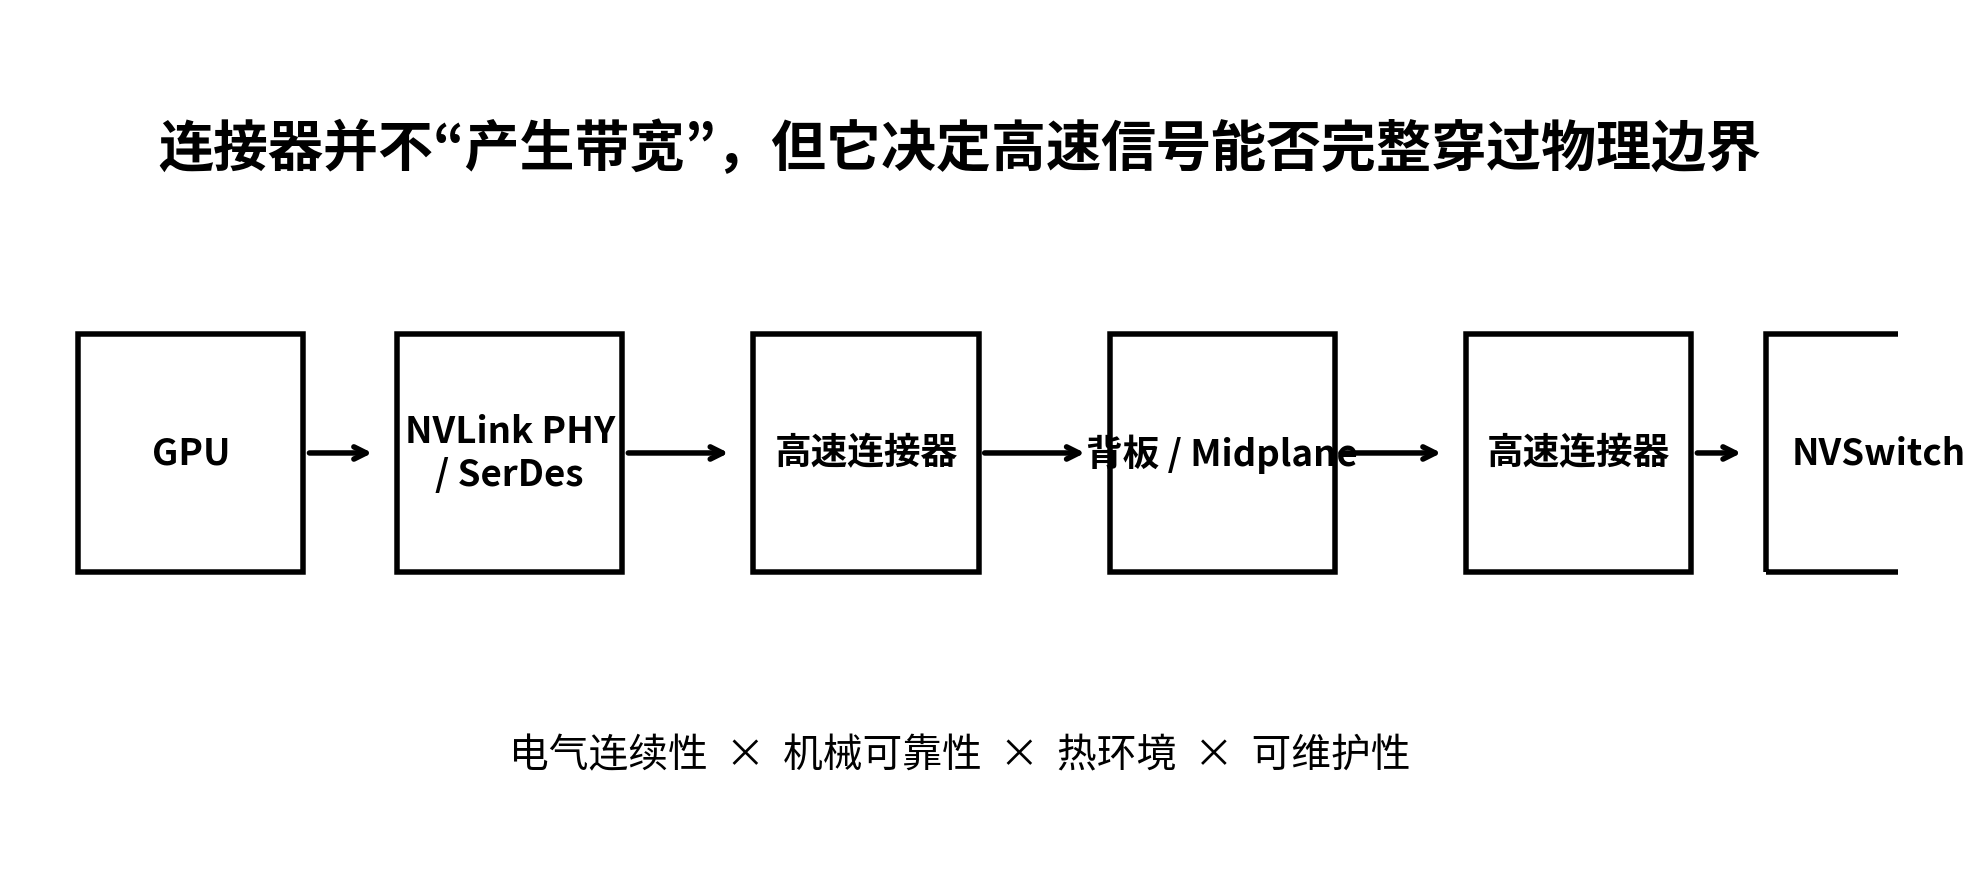
1. 先给结论:连接器不是带宽的来源,却可能成为带宽的边界
高速连接器最容易被低估,因为它通常只占整机BOM很小一部分,而且本身不执行计算、不存储数据,也不像交换芯片那样直接创造带宽。但在高速系统里,连接器是信号跨越“芯片/板卡/背板/模块”物理边界的必经节点。
当信号速率继续提高,任何阻抗突变、插损、回损、串扰、接触不稳定或机械偏差,都可能压缩系统的链路裕量。于是连接器从“机械连接件”逐渐变成高速通道的一部分。
产棱核心判断:连接器的产业价值,不能用单个连接器价格衡量,而要用“它是否限制了系统的有效带宽与可靠运行”衡量。
2. 为什么NVLink 6会把连接器问题放大?
NVIDIA公开资料显示,NVLink 6在Rubin平台上提供每GPU最高3.6 TB/s双向带宽,NVL72将72颗GPU组织为all-to-all通信域,机架级总带宽达到260 TB/s。NVIDIA同时强调,这一架构针对MoE路由、collective和同步密集型工作负载进行了优化。citeturn0search0turn0search1
这意味着通信不再是少数管理数据,而越来越成为计算本身的一部分。对于连接器而言,压力来自三个方向:
① 单通道速率越来越高;② 通道数量越来越多;③ 机架级连接密度越来越高。
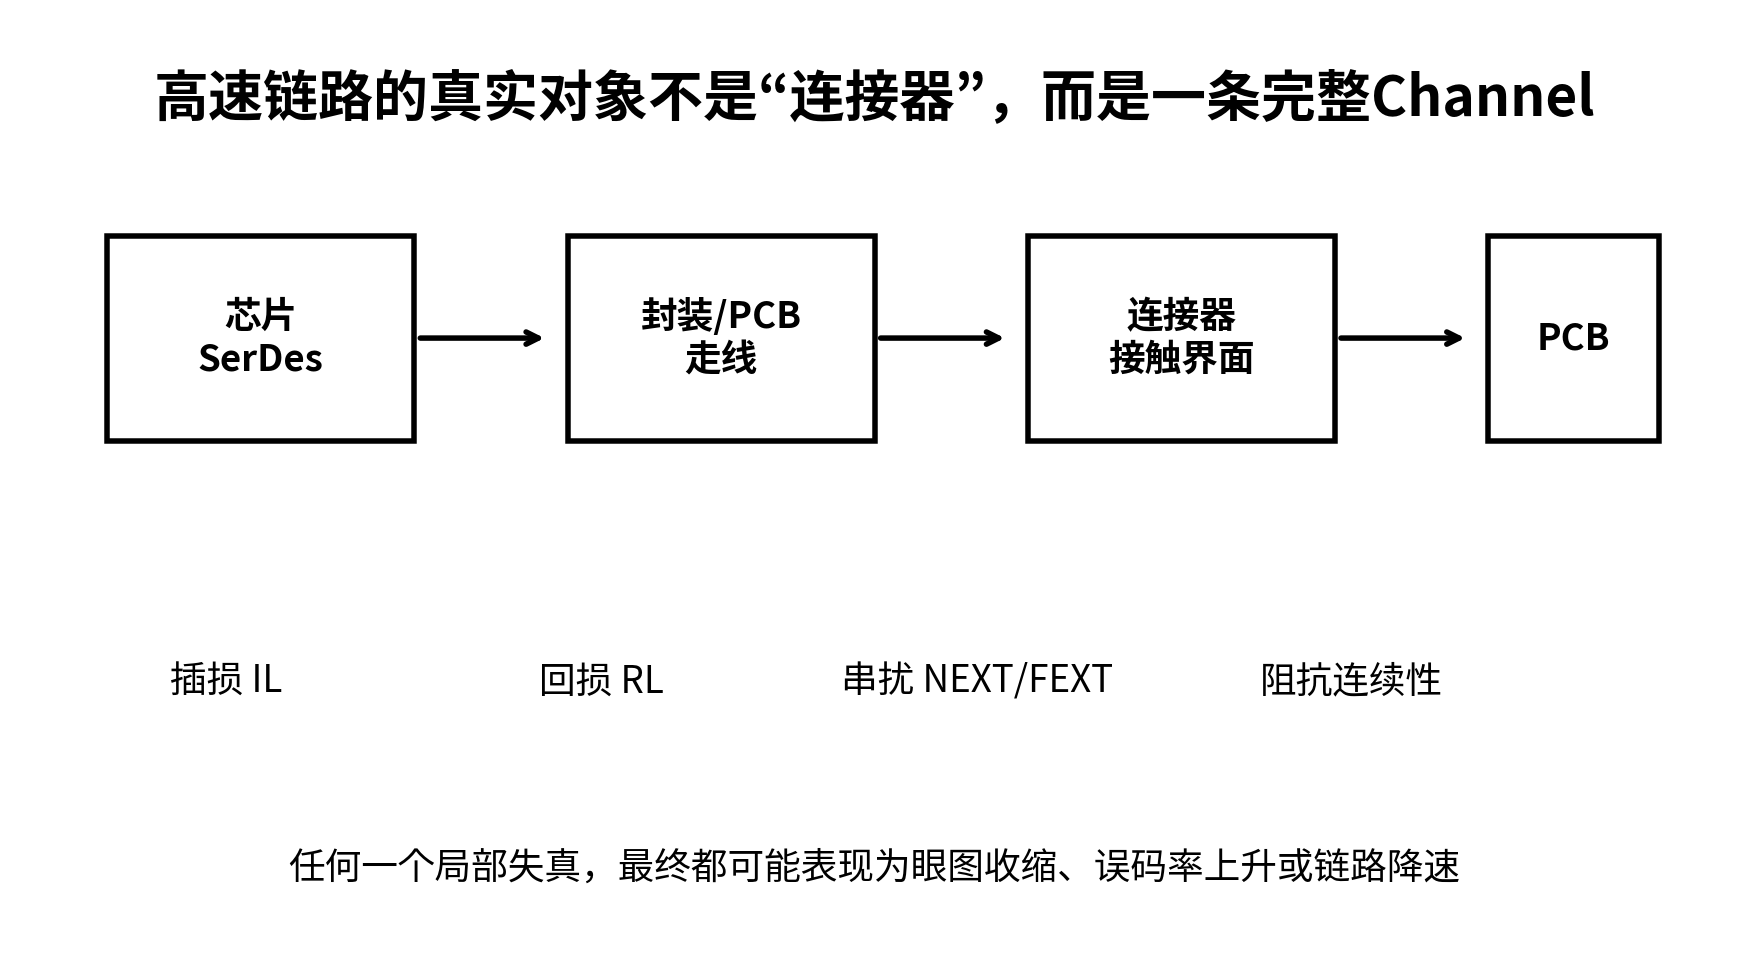
所以真正发生变化的是“通道预算”:系统必须把允许的损耗、反射、串扰、时延和抖动分配到芯片、封装、PCB、连接器和其他互连环节。
3. 第一层:速度——为什么高速连接器首先面对的是频率问题
数字信号虽然表现为0和1,但高速电信号的物理行为是连续波形。随着数据率提升,信号的高频成分变得越来越重要,连接器不再可以被简单看成一根理想导线。
| 变量 | 物理含义 | 对连接器的影响 |
| 插入损耗 IL | 信号通过通道后的能量衰减 | 越高越吃掉链路预算 |
| 回波损耗 RL | 阻抗不连续造成反射 | 影响眼图与接收端裕量 |
| 串扰 | 相邻通道电磁耦合 | 限制高密度布线 |
| 阻抗连续性 | 通道特性阻抗是否稳定 | 决定反射大小 |
| 时延/偏斜 | 不同通道传播时间差 | 影响多通道同步 |
| 接触电阻 | 端子接触界面损耗 | 影响电气与热可靠性 |
因此,连接器的设计目标不是单纯“让电流通过”,而是让高速信号尽可能像在连续传输线中一样通过连接界面。
4. 第二层:阻抗——为什么一个“插头”也要做电磁设计
高速链路通常要求控制阻抗。连接器内部存在端子、空气、塑胶、屏蔽结构和接地回路,几何尺寸的变化都会改变局部电磁场分布。
最典型的问题是连接器内部出现几何突变:端子间距变化、参考地路径改变、焊接区域过渡不平滑、连接器与PCB焊盘结构不连续,都可能形成阻抗不连续点。
高速连接器已经不是“机械件+金属针脚”,而是一个被纳入SI仿真的微型传输线结构。
5. 第三层:插损——为什么材料与结构开始变得重要
连接器插损并非只来自金属电阻。随着频率升高,导体表面粗糙度、趋肤效应、介质损耗、结构长度以及过渡区域都会影响信号衰减。
因此,高速连接器产业会同时涉及端子材料、镀层、塑胶介质、屏蔽结构、端子几何形状以及与PCB的过渡设计。
公开的高速连接器产品已经把112 Gbps PAM4、低串扰和4 Tbps以上聚合带宽作为产品能力展示,说明连接器已经进入与高速SerDes共同设计的阶段。这里的具体产品参数不能直接等同于NVLink 6连接器规格,但可以作为高速连接器产业技术演进的公开参照。citeturn0search9
6. 第四层:插损之外,更难的是串扰
AI机柜不是只有一条高速链路。NVL72包含大量并行高速通道。当通道密度提高后,相邻信号之间的电磁耦合会变得更加重要。
| 问题 | 来源 | 结果 |
| NEXT | 近端串扰 | 干扰发送端附近通道 |
| FEXT | 远端串扰 | 影响接收端眼图 |
| 电源噪声耦合 | PDN与高速信号相互影响 | 抖动/噪声上升 |
| 连接器内部耦合 | 端子间距过小 | 限制端口密度 |
因此,连接器“越小越好”并不成立。真正的目标是:在有限空间里实现更高密度,同时保持足够的电气隔离和参考地结构。
7. 第五层:为什么“插拔”本身也是一个工程问题
AI机柜不是一次性封装。NVL72采用模块化compute tray和switch tray架构,NVIDIA公开资料也强调模块化设计、可维护性以及交换tray热插拔等能力。citeturn0search5turn0search1
这会把连接器从“静态电气器件”变成“动态机械器件”。它必须同时满足:
插入力/拔出力、端子接触稳定性、磨损、氧化、微动、锁止、定位、公差累积以及维护后的重新插接一致性。
高速系统真正怕的不是一次实验室里跑通,而是跑了几年以后,在数千次热循环和维护动作之后仍然保持链路裕量。
8. 第六层:接触可靠性——为什么镀层与端子材料不能忽略
连接器的金属接触面需要在低接触电阻与长期可靠性之间平衡。端子材料需要兼顾导电性、机械强度、弹性和耐磨性;表面镀层则要控制氧化、腐蚀与磨损。
因此连接器产业的真正技术壁垒并不只在“能不能做到高速”,还在“能不能让高速性能稳定地维持”。这也是为什么量产一致性与可靠性验证在高端连接器中非常重要。
9. 第七层:机械结构为什么最终会反过来影响高速信号
连接器的机械尺寸、端子位置、公差和浮动都会改变电气结构。对于高密度板对板/背板连接,微小的装配偏差可能让部分通道的阻抗与接触状态发生变化。
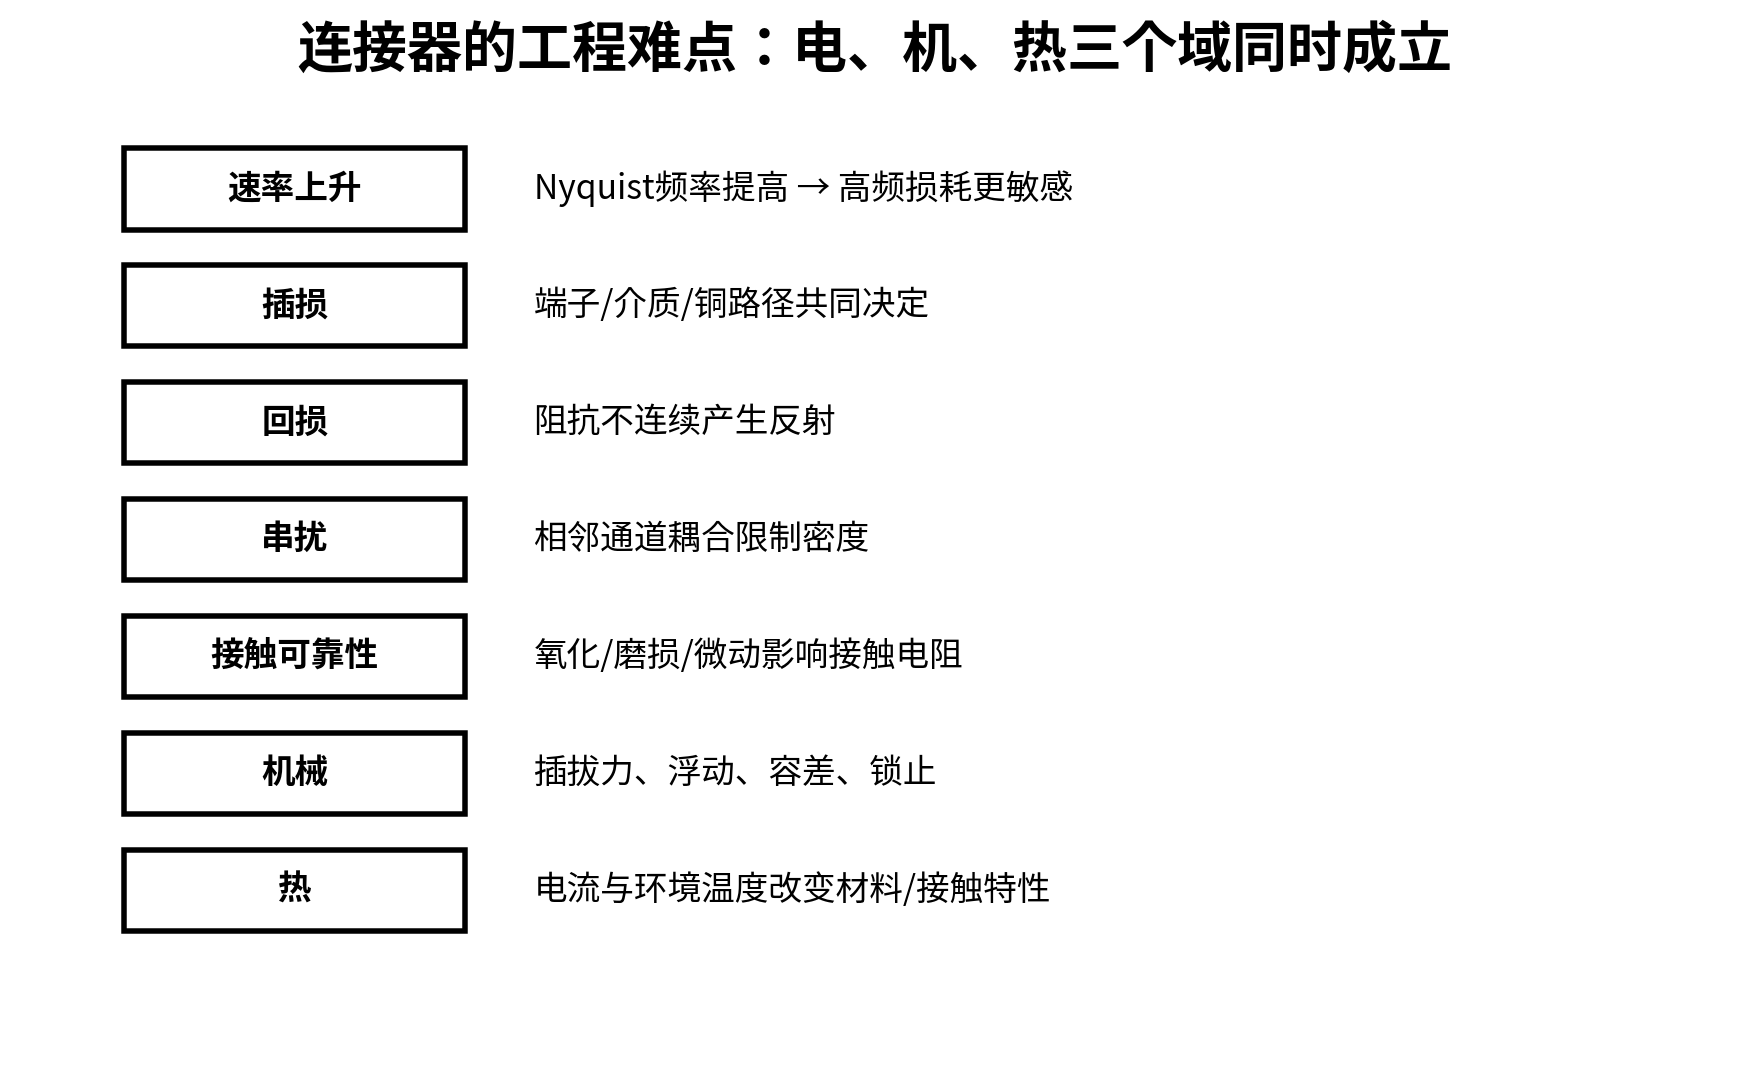
这就是高速连接器非常典型的“电—机耦合”:机械公差不是纯机械问题,而会最终进入SI预算。
10. 第八层:热——为什么高带宽系统也会把连接器带入散热问题
连接器本身通常不是最大的功耗来源,但高速通道数量巨大时,端子与接触区域仍然存在I²R损耗;同时连接器处于高功率GPU、NVSwitch、PCB和液冷系统附近,环境温度可能明显高于普通服务器。
温度会进一步影响材料、电阻、机械尺寸和接触可靠性。因此高端连接器需要在温度循环条件下验证,而不是只看室温电性能。
11. 第九层:为什么连接器必须与PCB一起设计
第11篇已经拆过正交无源背板:高速PCB不是孤立器件。到了连接器这一层,二者更不能分开。
连接器焊盘、PCB launch、过孔、背钻、参考平面、走线宽度和连接器端子几何结构必须共同优化。一个优秀的连接器,如果PCB过渡设计不好,整个Channel仍然可能失败。
连接器的真正产品不是“插头”,而是“连接器 + PCB launch + SI模型 + 验证数据”组成的完整高速通道接口。
12. 第十层:从单个连接器到整机架,密度才是真正的压力
NVL72的核心变化并不是只有3.6 TB/s这个数字,而是把大量高速链路集中到一个机架级计算域。NVIDIA公开资料显示,NVLink 6 Switch在NVL72中形成72 GPU的all-to-all非阻塞互连。citeturn0search1
因此连接器产业面对的是“高速度 × 高密度 × 高可靠性”的乘积,而不是单纯的速度提升。
| 维度 | 传统服务器 | AI机架趋势 |
| 通道速率 | 逐代提升 | 高速SerDes持续提升 |
| 连接密度 | 中等 | 显著提高 |
| 机械维护 | 普通板卡维护 | 模块化tray维护 |
| SI压力 | 局部优化 | 系统级Channel预算 |
| 热环境 | 相对温和 | 高功率密度 |
| 验证要求 | 产品级 | 系统级协同验证 |
13. 为什么AI高速互联升级,会把价值传导给连接器?
逻辑可以压缩成一条链:
GPU算力↑ → GPU间通信↑ → NVLink速率↑ → SerDes频率↑ → Channel预算变严 → PCB/连接器要求↑ → 材料、制造、SI验证难度↑
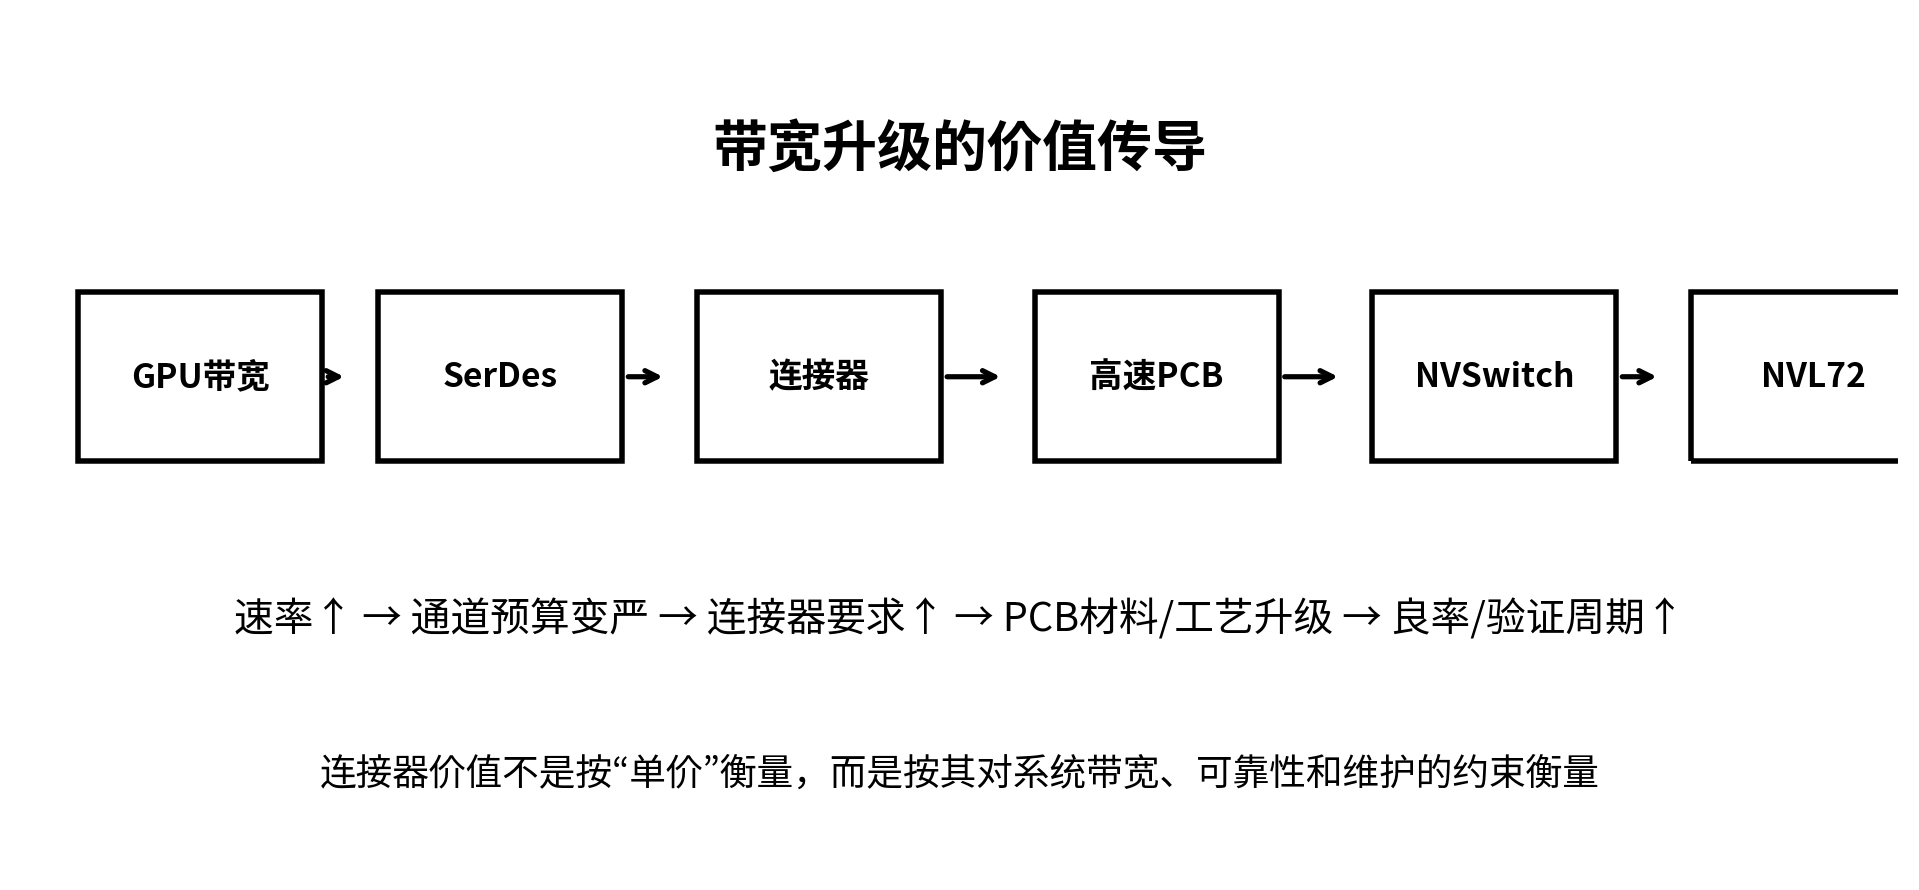
这不是“AI带动连接器需求”这么简单,而是AI系统架构的升级改变了连接器的技术门槛。
14. 连接器产业真正的价值池在哪里?
| 环节 | 价值来源 | 真正变量 |
| 端子材料 | 导电/弹性/耐磨 | 材料体系与镀层 |
| 精密冲压/成型 | 微米级几何一致性 | 模具与良率 |
| 塑胶/介质 | 介电性能与尺寸稳定 | 材料与成型 |
| 高速结构设计 | SI/PI性能 | 仿真与设计能力 |
| 自动化装配 | 一致性与效率 | 设备/检测 |
| 可靠性验证 | 长期稳定运行 | 测试体系 |
| 系统协同 | 整条Channel性能 | 客户认证与工程能力 |
因此不能简单用“连接器单价上涨”作为产业景气指标。真正值得跟踪的是高端高速连接器在AI机架中的渗透、单机连接密度、速率升级以及认证周期。
15. 什么情况下连接器会进入“瓶颈池”?
并不是所有连接器都具备瓶颈属性。真正可能进入瓶颈池的,是同时满足以下条件的产品:
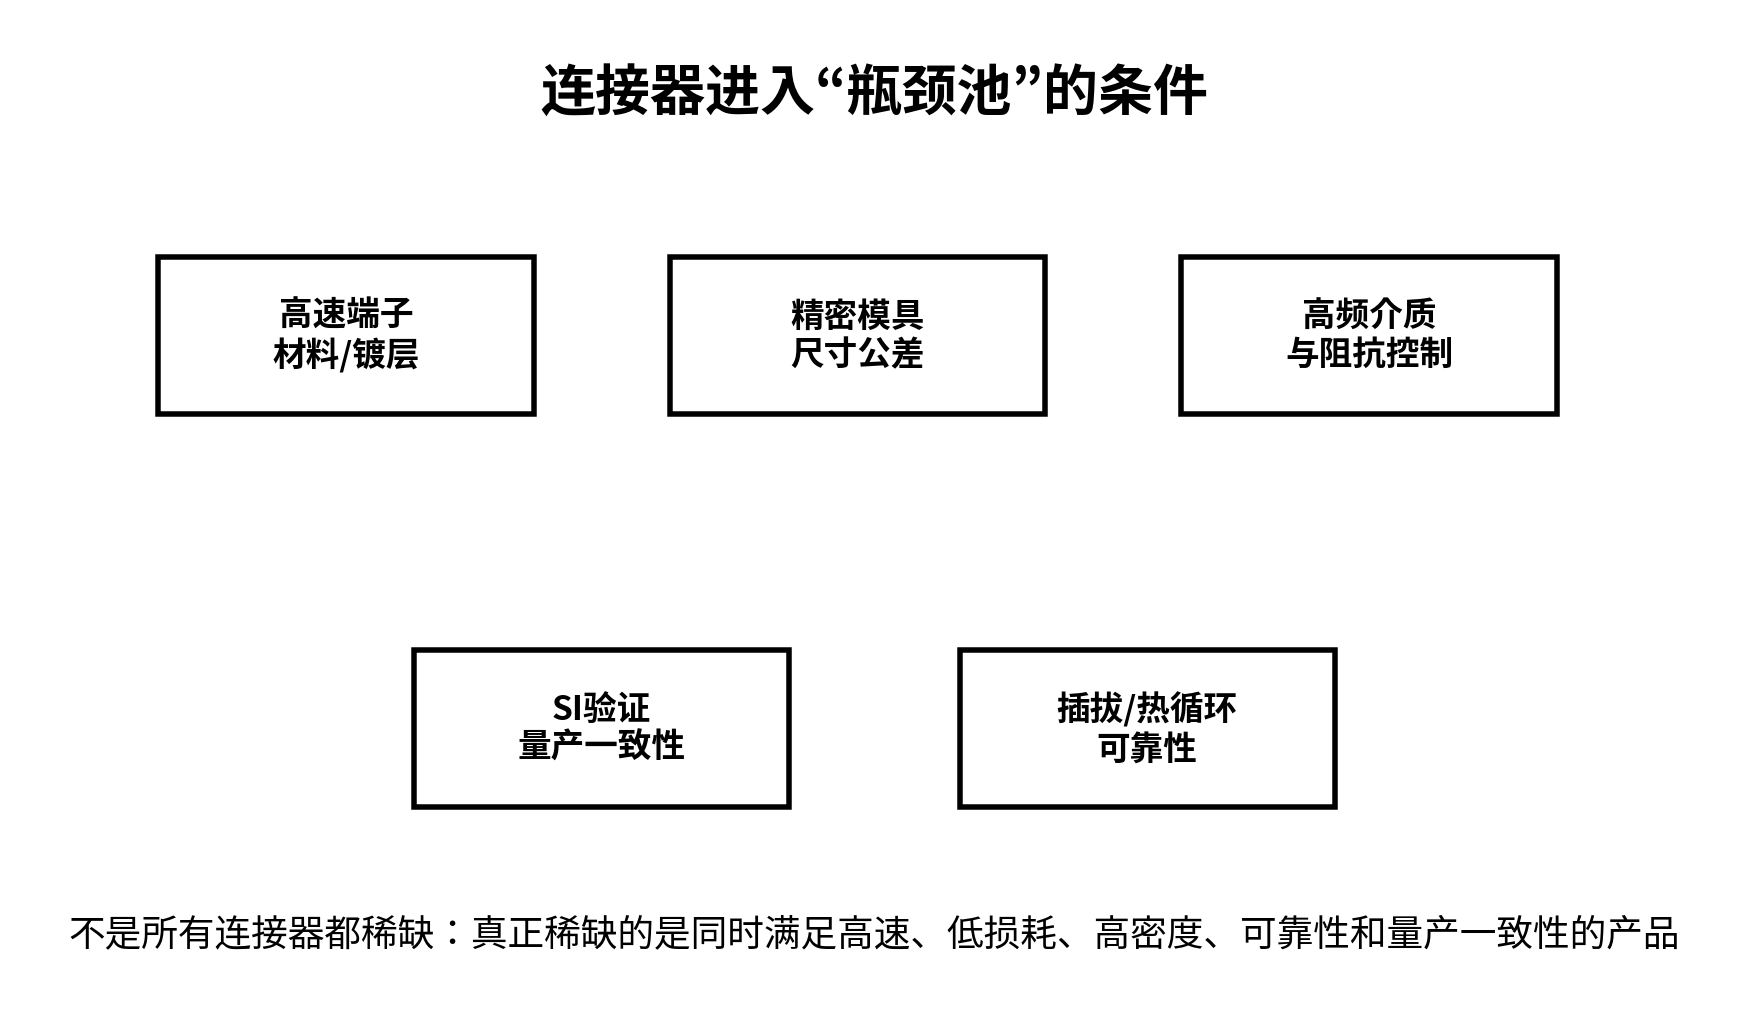
① 高速;② 高密度;③ 低损耗;④ 低串扰;⑤ 长期可靠;⑥ 可量产;⑦ 能通过头部AI平台认证。
产棱核心判断:高端连接器的稀缺性,本质上来自“性能 × 良率 × 认证 × 规模化”的同时成立。
16. 一个容易误判的问题:连接器是不是越贵越好?
不是。连接器的价值最终由系统约束决定。如果系统链路裕量充足,使用更昂贵的连接器并不自动创造价值;只有当系统速率、密度、可靠性或维护要求提升,使普通连接器无法满足时,高端连接器才会产生新增价值。
因此,产业研究应该关注“技术要求发生了什么变化”,再寻找谁能够满足,而不是先寻找“连接器概念股”。
17. 下一阶段:铜互连会不会被光互连替代?
这是连接器研究必须面对的边界。随着AI集群继续扩大,电互连的距离、功耗和信号完整性压力都会上升,光互连、硅光子以及CPO会获得更高关注。
但这不意味着铜连接器立即消失。NVIDIA当前公开的Vera Rubin NVL72仍采用NVLink spine,并公开描述了由模块化线缆盒组成的高速铜互连系统;与此同时,NVIDIA也在推进硅光子和未来更大规模的NVLink域。citeturn0search7turn0search0
所以更准确的判断是:光互连可能逐步进入更长距离、更高带宽的链路,而短距离板内、板间和模块级互连仍存在大量铜互连空间。
18. 产棱如何持续跟踪高速连接器?
| 跟踪变量 | 观察什么 | 为什么重要 |
| 单通道速率 | 112G/224G等高速SerDes演进 | 决定连接器频率压力 |
| 连接密度 | 每板/每tray高速端口数量 | 决定机械与SI密度 |
| 插损/回损 | 公开测试数据与设计指标 | 判断通道裕量 |
| 材料 | 低损耗介质、端子与镀层 | 决定性能和可靠性 |
| 良率 | 高端产品量产一致性 | 决定有效供给 |
| 认证 | 平台/ODM导入情况 | 决定真实商业化 |
| 铜→光 | 链路距离和拓扑变化 | 判断长期替代边界 |
19. 高速连接器价格 ≠ 高速连接器产业价值
连接器可能只是整机BOM中的小项,但它可能承担整个高速Channel的关键物理边界。因而其产业价值不能简单按照BOM占比推断。
反过来,也不能因为技术重要就直接推导出某个连接器厂商一定获得最大利润。最终还要看产品认证、良率、客户集中度、产能和竞争格局。
20. 最终拆解:真正被AI重新定义的是“连接”
过去,连接器是服务器里很容易被忽略的机械件;AI机架正在把它重新定义为高速计算系统的一部分。
GPU负责计算,NVLink负责通信,NVSwitch负责组织通信,而连接器负责让这套通信真正穿过物理世界。
当NVLink 6把单GPU带宽推向3.6 TB/s、NVL72形成260 TB/s级机架通信域后,连接器已经不能再按照传统“插头”理解。它实际上成为GPU、PCB、交换芯片和机架结构之间的高速物理接口。citeturn0search0turn0search1
产棱最终判断:高速连接器不是AI硬件里最大的价值池,却可能成为高速互连继续升级时越来越重要的工程瓶颈。真正值得跟踪的不是“连接器涨价”,而是AI系统对连接器提出了什么新的物理要求,以及谁能够把这些要求稳定地量产出来。
附录|关键数据与研究边界
1. NVIDIA公开资料:NVLink 6为每GPU 3.6 TB/s双向带宽;NVL72为72 GPU all-to-all,机架级总带宽260 TB/s。
2. NVIDIA公开资料:Vera Rubin NVL72采用18个compute trays与9个NVLink switch trays;NVLink spine位于机架后部。
3. 高速连接器公开产品资料可用于说明行业技术能力,但不能据此推导NVLink 6具体连接器供应商或具体料号。NVIDIA并未在上述公开资料中披露完整连接器供应链。
4. 本文讨论的是工程传导逻辑,不构成对任何上市公司、供应商或证券的投资建议。