产棱拆解|Optical I/O深度拆解:GPU封装里究竟如何塞进光?
从 GPU封装内部往外看:HBM、Compute Die、I/O Die、硅光PIC、Laser、ABF、先进封装到底怎么拼成一个系统。
一、核心结论:Optical I/O真正改变的是“GPU的边界”
前面几篇我们一直在追踪一个方向:
传统光模块
→ CPO
→ NPO
→ Optical I/O
表面上看,是光学器件不断靠近计算芯片。
但从GPU内部看,真正发生的事情其实是:
GPU原本只有“电I/O”,未来可能同时拥有“电I/O + 光I/O”。
也就是说,未来一颗AI加速器不一定只是:
Compute Die + HBM
而可能逐渐演化成:
**Compute Die
- HBM
- I/O Die
- Optical I/O
- PIC
- Laser
- Advanced Packaging**
最终形成一个高度集成的:
计算 + 存储 + 电互连 + 光互连系统。
这才是Optical I/O真正值得研究的地方。
二、先从一颗今天的AI GPU开始
先不要急着加入光。
今天典型的高性能AI加速器,可以粗略理解成:
Compute Die负责:
计算。
HBM负责:
提供巨大的本地内存带宽。
Substrate负责:
把芯片与PCB连接起来。
PCB负责:
把整个系统连接出去。
这是今天高性能AI芯片的基本逻辑。
三、但这里存在一个非常重要的问题
GPU内部计算越来越快。
HBM带宽越来越高。
但是GPU的数据最终还是要:
走出芯片。
例如:
GPU A
需要把数据发送给:
GPU B
或者发送给:
Switch
或者连接:
CPU / Storage / Network
这时候数据必须从:
Compute Die
走到:
Package
再走到:
PCB
再走到:
Network
于是:
GPU内部计算速度和外部I/O能力之间开始出现矛盾。
这就是Optical I/O真正要解决的问题。
四、为什么不能简单地继续增加电I/O?
因为电互连并不是无限扩展的。
你可以不断增加:
- SerDes速率
- Lane数量
- PCB层数
- 铜线数量
- Retimer
- Connector
但是最终都会遇到:
功耗
面积
信号完整性
距离
散热
的问题。
特别是:
单lane速度越来越高以后,电信号能够可靠传播的距离越来越短。
所以产业面对的不是:
“电能不能做到?”
而是:
“继续用电做高速I/O,成本和功耗是否还值得?”
五、于是GPU内部出现了一个新的角色:I/O Die
I/O Die:
Input / Output Die
输入输出芯片
它可以理解成:
计算芯片和外部世界之间的交通枢纽。
于是系统可能变成:
这样就出现了一个非常重要的架构思想:
Compute Die负责算,I/O Die负责连接。
六、为什么I/O Die特别适合成为“光的入口”?
因为:
Compute Die
最重要的是:
算力密度。
而:
I/O Die
最重要的是:
数据进出。
所以如果未来需要加入:
Optical I/O
把光学功能放在I/O Die附近,逻辑上就非常自然。
于是:
这样就把:
计算
和:
通信
进行了分层。
七、但这里马上产生一个问题
Optical I/O究竟是一颗独立芯片,还是直接做进GPU?
现实中不能简单二选一。
未来可能存在多种架构:
架构A:独立Optical Engine
GPU封装旁边:
Optical Engine
通过极短电连接连接GPU。
架构B:Optical I/O Die
把部分光电功能集成到:
I/O Die
附近。
架构C:Photonic Chiplet
把:
PIC
做成一个独立Chiplet。
再与:
Compute Die
通过先进封装连接。
架构D:更深度的光电共封装
未来甚至可能:
Compute + HBM + I/O + Photonics
高度集成。
所以不要把Optical I/O理解成一个固定产品。
它更像是一条:
光学不断向封装内部渗透的技术路线。
八、现在把HBM放进来
前面研究HBM的时候,我们看到一个非常重要的事实:
HBM不是简单的“高容量内存”。
它真正的价值是:
通过极短距离和极宽接口,为AI计算芯片提供巨大的内存带宽。
为什么HBM要贴近GPU?
因为:
GPU ↔ HBM
如果距离太远:
- 功耗增加
- 带宽受限
- 信号完整性恶化
所以:
HBM
被放到:
GPU封装内部。
九、现在出现一个非常有意思的对称关系
GPU内部有:
Memory Wall
于是:
HBM
被不断拉近GPU。
GPU外部有:
Communication Wall
于是:
Optical I/O
也开始不断拉近GPU。
所以未来GPU封装实际上出现两个方向的“靠近”:
上面:
HBM
解决:
数据怎么快速进入计算核心。
下面:
Optical I/O
解决:
数据怎么快速离开计算核心。
这就是下一代AI封装非常重要的两个I/O方向。
十、所以HBM和Optical I/O其实解决的是两个不同问题
HBM
解决:
Memory Bandwidth
内存带宽。
Optical I/O
解决:
Communication Bandwidth
通信带宽。
因此未来AI芯片可能同时需要:
更宽的Memory I/O + 更强的Optical I/O。
这两个方向会共同推动先进封装。
十一、这时候ABF终于真正进入整个系统
前面我们单独研究过:
ABF
现在把它放进GPU系统。
大致可以理解:
ABF:
Ajinomoto Build-up Film
味之素增层膜
是高端封装基板中的关键材料体系。
它承担大量:
- 高密度布线
- 电气绝缘
- 微细线路构建
- 芯片与PCB之间的连接
所以当:
Compute Die
HBM
I/O Die
Optical I/O
越来越多地进入一个封装时:
封装基板的布线密度和电性能压力也会同步增加。
十二、为什么光进入封装以后,ABF不会消失?
因为:
光解决的是高速通信的一部分问题,不是所有电连接问题。
封装里面仍然需要大量:
- 电源
- 控制
- 管理
- 低速信号
- 中速信号
- 芯片间连接
所以:
ABF
仍然承担大量电连接任务。
真正发生变化的是:
哪些信号继续走电,哪些信号开始走光。
十三、于是未来封装可能出现一个非常重要的分工
可以粗略理解:
芯片内部
Electrical
芯片之间的超短距离
Electrical
封装边缘
Electrical + Optical
封装之外
越来越多:
Optical
于是:
电负责非常短的距离,光负责越来越长的高速距离。
十四、但Optical I/O真正困难的地方在这里
现在我们假设:
PIC
已经做出来了。
Laser
也做好了。
问题来了:
怎么把它们放进GPU封装?
这不是简单地把一颗芯片放上去。
因为光学连接有一个特殊要求:
位置必须非常精准。
十五、为什么光学对位置特别敏感?
电子信号:
只要线路连接正确,一定范围内的几何误差通常可以容忍。
光信号:
Fiber
和:
Waveguide
之间必须实现高精度耦合。
如果位置发生偏移:
Coupling Loss
就会上升。
因此Optical I/O会产生一个传统电子封装没有那么强烈的问题:
光学对准。
十六、于是出现Fiber Array
Fiber Array:
光纤阵列
它不是一根光纤。
而是:
把大量光纤按照非常精确的几何位置排列起来。
例如:
每一根对应一个光通道。
然后需要把:
Fiber Array
准确地连接到:
PIC
上。
所以:
PIC制造
和:
Fiber Coupling / Packaging
实际上是两个不同的技术难题。
十七、这就是Optical I/O和传统芯片封装最大的不同之一
传统芯片封装主要处理:
Electrical Connection
而Optical I/O需要同时处理:
Electrical Connection
Optical Connection
Thermal Management
Mechanical Alignment
所以它实际上是:
四维封装问题。
十八、现在把Laser放进来
Laser是整个系统中最特殊的器件之一。
因为:
PIC
可以用成熟半导体工艺大规模制造。
但是:
Laser
涉及III-V材料体系。
例如:
InP(磷化铟)
GaAs(砷化镓)
所以:
硅光和激光器天然存在材料体系差异。
十九、为什么不能简单把Laser做进硅里?
因为硅本身并不适合直接成为高性能激光光源。
所以产业需要解决:
Silicon
和:
III-V
之间的结合。
这就产生:
Hybrid Integration
Heterogeneous Integration
等技术路线。
简单理解:
把不同材料体系的优势组合起来。
二十、因此未来Optical I/O的真正结构可能是“异质集成”
例如:
这就是:
III-V光源 + Silicon Photonics
共同工作。
二十一、为什么Laser可能继续外置?
因为现在又回到我们之前发现的那个矛盾:
GPU非常热。
Laser非常怕热。
于是:
GPU
PIC
可以靠近。
但是:
Laser
不一定必须和它们全部共封装。
因此未来可能形成:
Remote Laser
或者:
External Laser Source
架构。
这意味着:
光源和光处理可以空间分离。
二十二、这实际上非常像电源架构
你可以把它理解成:
GPU封装内部:
PIC
负责:
处理光。
远处:
Laser
负责:
提供光。
两者通过光连接。
这样就可以把最怕热的器件从最热区域拿出去。
二十三、现在把所有东西放在一张图里
一颗未来AI加速器可以粗略理解成:
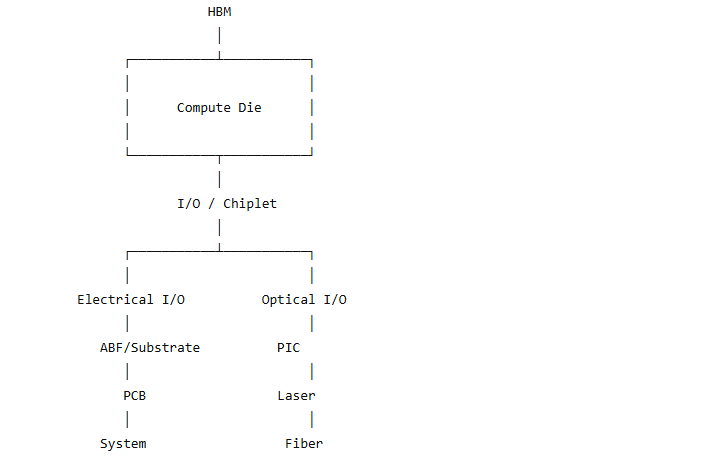
注意:
这不是某一家厂商已经固定采用的标准产品结构,而是为了理解产业关系建立的功能架构图。
实际产品会根据架构,把PIC、Laser、I/O Die、Driver、TIA等放在不同位置。
二十四、现在可以真正理解Chiplet为什么重要
Chiplet:
芯粒
的核心意义之一,就是:
不再要求所有功能都由一颗巨型单芯片完成。
于是可以拆成:
Compute Chiplet
I/O Chiplet
Memory Interface
Optical Chiplet
等等。
然后利用先进封装把它们重新组合。
这意味着:
未来“芯片”的概念本身正在发生变化。
一块封装可能就是一个完整计算系统。
二十五、这对GPU设计意味着什么?
过去:
GPU = 一颗巨大芯片。
未来:
GPU系统 = 一个封装里的多个功能Chiplet。
例如:
Compute
↓
HBM
↓
I/O
↓
Optical I/O
↓
Network
全部在一个高度集成的系统里。
所以:
先进封装的重要性越来越接近芯片设计本身。
二十六、这也是为什么CoWoS等先进封装技术如此重要
以2.5D/3D先进封装体系为例,核心思想都是:
让不同芯片在物理空间上越来越近。
传统:
芯片 → PCB → 芯片
现在:
芯片 → Interposer / Substrate → 芯片
进一步:
芯片 → 3D堆叠
再进一步:
Compute + HBM + I/O + Photonics
高度集成。
所以:
Optical I/O不是独立于先进封装之外的一项技术,它本质上是先进封装继续向光域扩展。
二十七、但是光进入封装后,热问题会更加严重
这是不能绕开的。
一个AI加速器封装里面可能同时有:
Compute Die
HBM
I/O Die
PIC
Laser
这些器件对温度的要求完全不同。
特别是:
Compute Die
希望:
强力散热。
Laser
希望:
相对稳定、低温。
所以一个封装内部可能出现:
不同器件对温度的需求冲突。
二十八、因此未来先进封装不只是“把芯片放得更近”
真正的先进封装已经变成:
电
光
热
机械
四个维度共同优化。
这也是为什么:
未来封装工程师的价值会越来越高。
因为简单的“芯片连接”已经不够。
需要解决:
信号完整性
电源完整性
光学耦合
热管理
机械应力
可靠性
二十九、甚至HBM也会影响Optical I/O
这点很容易被忽略。
HBM越来越多以后:
封装面积
越来越紧张。
于是:
HBM
和:
Optical I/O
会争夺封装边缘和布线资源。
因此未来封装布局会变成一个真正的空间优化问题:
HBM放哪里?
Compute Die放哪里?
I/O Die放哪里?
Optical I/O放哪里?
Fiber从哪里出来?
热从哪里出去?
三十、这意味着未来GPU封装会出现“光学边缘”
这是一个非常值得理解的概念。
因为光纤不可能从芯片中心穿进去。
因此:
Optical I/O
很可能需要位于:
封装边缘。
于是:
这就产生一个新的工程问题:
如何让封装边缘的光I/O,在不影响内部计算和HBM布局的情况下,提供足够高的带宽密度?
三十一、这就是“光学I/O密度”
未来非常重要的指标之一,不只是:
Gbps
而是:
每毫米封装边缘能够提供多少光带宽。
因为封装边缘空间有限。
如果:
1 mm边缘
只能放很少光通道:
就无法满足未来GPU的通信需求。
因此未来可能同时追求:
Bandwidth density
Power efficiency
Coupling efficiency
Packaging density
三十二、最终可能出现一个新的封装瓶颈
前面:
电互连
是瓶颈。
CPO:
热和耦合
变成瓶颈。
Optical I/O:
可能进一步出现:
封装边缘光I/O密度
成为瓶颈。
也就是说:
光不是没有限制。
只是:
瓶颈从“铜线怎么跑”转移到了“光怎么进入封装”。
三十三、把整条产业传导重新串起来
现在终于可以把你前面研究的所有东西连接起来:
这条链已经不是单纯的“光通信产业链”。
而是:
AI算力产业链 → 网络产业链 → 光通信产业链 → 半导体产业链 → 先进封装产业链
全部开始融合。
三十四、所以未来最值得研究的不是“CPO市场有多大”
而是一个更底层的问题:
AI系统每增加1单位计算能力,需要增加多少通信带宽?
然后继续问:
这些通信带宽里面,有多少仍然可以用电完成?
再问:
什么时候必须转向光?
最后:
光转换的位置应该放在哪里?
于是得到:
Pluggable
↓
CPO
↓
NPO
↓
Optical I/O
这就不是预测某个产品,而是在追踪:
物理约束如何推动架构迁移。
三十五、产棱真正应该建立的不是“CPO产业链”
而是一张:
AI算力互连瓶颈迁移图
核心节点可以这样理解:
算力
↓
内存带宽
↓
芯片I/O
↓
封装内互连
↓
封装外互连
↓
机架内互连
↓
机架间互连
↓
数据中心网络
每一层都有:
电
和
光
之间的边界。
而这个边界正在向计算核心移动。
三十六、HBM与Optical I/O最终形成两个“数据高速公路”
未来一颗AI加速器可以想象成:
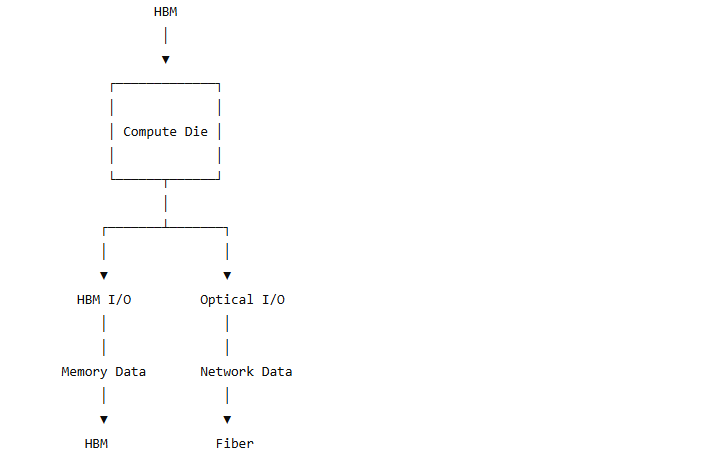
左边:
HBM
解决:
计算核心的数据供应。
右边:
Optical I/O
解决:
计算核心的数据输出。
因此:
HBM和Optical I/O实际上是AI加速器未来两个非常重要的“数据高速公路”。
三十七、这会重新定义先进封装的价值
过去先进封装主要解决:
芯片之间怎么连接。
未来则要同时解决:
芯片怎么连接
HBM怎么连接
光怎么连接
热怎么散
电源怎么供
因此未来高端AI封装可能成为:
AI算力系统的核心基础设施,而不是简单的芯片后道工艺。
三十八、最终判断:Optical I/O真正改变的是“计算机的物理边界”
过去我们可以很明确地说:
芯片
在这里。
光模块
在外面。
网络
在更外面。
但是Optical I/O出现以后:
芯片
和
网络
的边界开始模糊。
未来一个AI加速器可能天然拥有:
Compute
Memory
Electrical I/O
Optical I/O
甚至:
Network Function
这意味着:
未来高性能AI芯片可能越来越像一个完整的“计算节点”,而不是单纯的一颗计算芯片。
三十九、从产棱视角,真正需要继续追踪的变量
如果把这一方向纳入产业跟踪,核心不是每天追踪“CPO新闻”,而应该跟踪以下变量:
| 层级核心问题 | |
| Compute | AI算力增长速度 |
| HBM | 带宽是否继续成为瓶颈 |
| SerDes | 单lane速率还能提高多少 |
| Electrical I/O | 电互连距离与功耗 |
| PIC | 调制速度、损耗、良率 |
| Laser | 功耗、温度、寿命 |
| Optical I/O | 带宽密度、pJ/bit |
| Coupling | 光纤到PIC的耦合损耗 |
| Packaging | 光电共封装良率 |
| ABF/Substrate | 布线密度与信号完整性 |
| Thermal | Compute + HBM + Photonics热管理 |
| Fiber | 封装边缘光纤密度 |
| System | 每Tbps功耗与成本 |
最终要回答的不是:
“Optical I/O会不会成为下一个热点?”
而是:
“在AI算力继续增长的情况下,哪一层物理互连首先无法继续扩展?”
如果答案从:
PCB
迁移到:
封装
再迁移到:
Optical I/O
那么真正的产业机会就会随着这堵“墙”的移动而不断迁移。
四十、最终把整个AI加速器系统看成一个整体
现在我们终于可以把此前拆开的几个专题真正拼起来:
GPU / XPU
负责:
计算
HBM
负责:
内存带宽
I/O Die / Chiplet
负责:
数据进出
PIC
负责:
光信号处理
Laser
负责:
光源
Driver / TIA
负责:
光电转换接口
Advanced Packaging
负责:
把这些东西放在一起,并保证它们能工作
ABF / Substrate
负责:
高密度电连接
CPO / NPO / Optical I/O
负责:
把光逐步推进到计算核心
Fiber
负责:
把数据从一个计算节点送到另一个计算节点
最终形成:
Compute + HBM + Electrical I/O + Optical I/O + Advanced Packaging + Network
这才是下一代AI加速器真正完整的物理系统。
而CPO只是这个巨大变化中的一个阶段。
四十一、最终的产业逻辑
把所有东西压缩成一句话:
AI算力越强,数据交换越多;数据交换越多,高速电互连越难;高速电互连越难,光电转换就越靠近计算核心;光越靠近计算核心,先进封装、Laser、PIC、光耦合和散热的重要性就越高。
因此:
AI算力增长
↓
HBM增长
↓
通信增长
↓
SerDes升级
↓
电互连撞墙
↓
CPO
↓
NPO
↓
Optical I/O
↓
光进入GPU封装
↓
Photonic Chiplet
↓
计算与光互连逐渐融合
这条链条,才是研究未来AI基础设施最值得建立的底层坐标系。
结语:下一堵墙在哪里?
到这里,我们已经从:
PCB / CCL
一路拆到了:
GPU封装 → HBM → Chiplet → PIC → Laser → Optical I/O。
下一步就不能继续简单往器件层拆了。
真正值得追问的是:
如果光已经进入GPU封装,那么GPU内部还需要电互连吗?
答案当然是需要。
但接下来真正有意思的问题是:
哪些距离必须继续用电?哪些距离可以直接用光?
以及更进一步:
如果未来GPU、HBM、I/O Die、PIC甚至光源全部进入同一个先进封装,整个封装的“下一堵墙”究竟是功耗、散热、带宽、光耦合,还是制造良率?