产棱拆解 | AI Factory六大产业链瓶颈传导地图,GPU、HBM、光通信、PCB/CCL、液冷、电力如何共同构成下一代AI基础设施
本文 4 节
AI Factory六大产业链瓶颈传导地图——GPU、HBM、光通信、PCB/CCL、液冷、电力如何共同构成下一代AI基础设施
一、不要再把AI产业链理解成六条独立赛道过去研究AI产业链,通常是这样拆:
GPU是一条链。
HBM是一条链。
光通信是一条链。
PCB/CCL是一条链。
液冷是一条链。
电力是一条链。
然后分别研究:
市场空间、竞争格局、技术路线、公司份额。
这种研究方式可以知道“有什么”,但很难回答真正重要的问题:
为什么这个环节现在突然变得紧?
以及:
如果这个瓶颈被解决,下一堵墙会移动到哪里?
AI Factory真正的产业结构应该理解成:
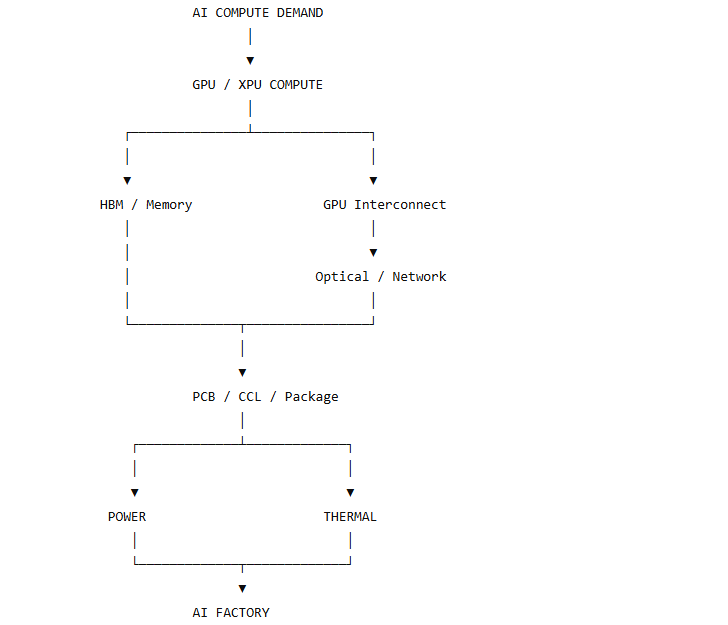
因此六大产业实际上共同回答三个问题:
第一:算什么?
GPU / XPU
第二:怎么传?
HBM + 光通信 + PCB/CCL
第三:怎么让它持续运行?
液冷 + 电力
这才是完整的AI Factory。
二、先建立六大产业链的物理位置把六条产业链放到AI Factory里面:
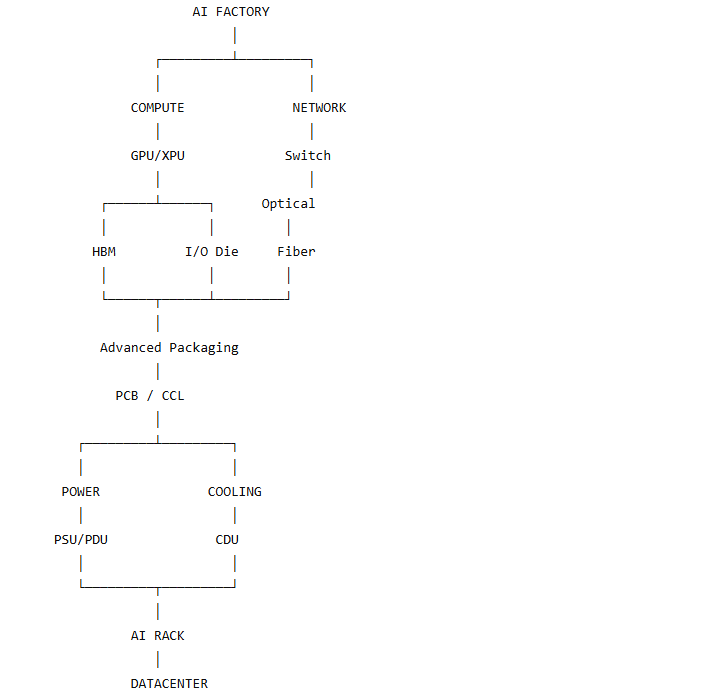
六条链的位置不同。
因此它们的瓶颈类型也不同。
三、第一条链:GPU——整个系统的“计算需求发动机”GPU是AI Factory最容易理解的一条链。
但研究GPU最容易犯的错误也是:
只看GPU出货量。
真正应该研究的是:
单位AI计算能力需要多少GPU?
以及:
模型规模增长速度是否继续超过单GPU性能增长?
如果模型越来越大:
那么GPU需求自然增长。
但这里马上产生第一个关键问题:
GPU性能提升以后,GPU数量是否可以同步减少?
如果单GPU算力增长速度:
快于AI工作负载增长
那么GPU数量增长可能放缓。
反过来:
如果AI计算需求增长:
快于单GPU性能提升
那么GPU数量继续增加。
所以:
GPU需求不是由“AI很火”决定,而是由工作负载增长与单芯片计算效率之间的差决定。四、GPU产业链真正需要跟踪的变量
应该关注:
| 变量观察意义 | |
| 单GPU计算性能 | 单芯片供给能力 |
| GPU功耗 | 机柜功率压力 |
| HBM带宽 | 内存约束 |
| HBM容量 | 模型承载能力 |
| GPU互连带宽 | 集群效率 |
| GPU数量/Cluster | 集群规模 |
| 单位计算能耗 | AI Factory经济性 |
| 先进封装能力 | 高端GPU最终产能 |
因此GPU并不是孤立的。
GPU性能越高:
HBM需求越高。
GPU数量越多:
网络需求越高。
GPU功耗越高:
液冷和电力需求越高。
GPU I/O越快:
PCB/CCL和光通信压力越高。
所以:
GPU实际上是六条产业链的需求源头。五、第二条链:HBM——GPU的数据燃料
GPU算得再快:
如果没有足够的数据供应:
计算核心就会闲置。
因此HBM解决:
Compute → Memory的数据供应问题。
可以把它理解为:
GPU是发动机。
HBM是燃料供应系统。
但普通燃料不够。
GPU需要的是:
极高速、大带宽、低距离的数据供应。六、HBM的真正瓶颈不是简单的“容量”
HBM至少存在四个不同约束:
第一:DRAM Die
存储芯片本身。
第二:Stacking
多层DRAM堆叠。
第三:TSV
Through-Silicon Via,硅通孔。
第四:Advanced Packaging
HBM如何与GPU进行高密度连接。
因此:
任何一层受限:
最终都可能成为HBM供给瓶颈。
七、HBM最值得跟踪的是“带宽需求是否超过供给增长”GPU性能提升:
↓
每秒处理的数据量增加
↓
HBM带宽需求增加
↓
HBM容量增加
↓
HBM Stack层数增加
↓
先进封装需求增加
↓
封装产能成为约束
于是HBM产业链可能出现:
DRAM不是最紧。
而是:
HBM封装/先进封装成为最紧。
这就是典型的:
瓶颈从芯片制造向封装迁移。八、第三条链:光通信——解决GPU之间的数据移动
如果HBM解决:
GPU ↔ Memory
那么光通信解决:
GPU ↔ GPU
以及:
GPU ↔ Switch
因此AI集群规模扩大以后:
这就是光通信产业需求最核心的物理来源。
九、光通信产业链其实要继续向下拆不能把“光通信”看成一个整体。
至少需要拆成:
而未来进一步变成:
所以光通信的产业机会也会随着架构迁移而变化。
十、光通信当前真正需要观察的不是“光模块销量”而是:
高速电连接是否开始成为系统瓶颈。
因此最重要的工程变量包括:
SerDes速率
单通道数据速率。
Electrical Reach
高速电信号能够可靠传输的距离。
Energy per Bit
每比特数据移动所消耗的能量。
Optical Coupling Loss
光耦合损耗。
Laser Efficiency
激光器效率。
Optical Density
单位空间内的光连接能力。
这些变量比“光模块市场规模”更接近真正的产业瓶颈。
十一、第四条链:PCB / CCL——仍然存在的电连接基础设施光通信发展以后:
PCB并不会消失。
原因是AI服务器仍然存在大量:
- 电源
- 控制
- 管理
- 高速电信号
- 芯片连接
因此PCB依然是:
AI服务器内部的电连接底座。十二、CCL真正解决的是高速信号能否跑过去
CCL:
Copper Clad Laminate,覆铜板
决定PCB高速信号传输性能的重要基础之一。
随着:
25.6G
→ 56G
→ 112G
→ 224G
甚至更高速率
PCB面临越来越严重的:
- 插入损耗
- 介质损耗
- 导体损耗
- 串扰
- 阻抗控制问题
所以高端CCL的价值本质上是:
让高速电信号在越来越短的电距离里仍然保持信号完整性。十三、这里出现一个非常重要的产业关系
PCB/CCL和光通信不是简单的竞争关系。
实际上是:
高速电连接越困难,光通信越有机会。
因此可以形成:
所以:
PCB/CCL越难做,并不意味着它马上被光取代。
反而可能出现:
PCB/CCL继续升级 + 光连接同步增加。
最终形成:
短距离电连接 + 长距离光连接。
十四、第五条链:液冷——AI算力的“散热基础设施”前四条链主要围绕:
数据。
液冷开始解决:
热。
AI GPU最大的问题之一是:
单位面积产生的热越来越高。
于是:
液冷不是简单的“把风冷换成水冷”。
它实际上是:
AI算力继续提高以后,热传导路径必须重新设计。十五、液冷产业链应该拆成什么?
完整液冷系统:
因此液冷不是一个单一产品。
真正需要研究:
- 冷板
- 接头
- 管路
- 泵
- CDU
- 换热器
- 冷却液
- 机柜系统
- 数据中心基础设施
随着液冷普及:
新的问题会出现:
漏液。
腐蚀。
材料兼容性。
连接器可靠性。
维护难度。
流量平衡。
因此未来液冷产业竞争并不是:
谁能把温度降低最多。
而是:
谁能在高功率密度下实现长期可靠运行。
这又是一次典型的:
瓶颈迁移。
十七、第六条链:电力——AI Factory最终的能源约束现在来到最底层。
GPU需要电。
HBM需要电。
Switch需要电。
Optical需要电。
液冷系统也需要电。
所以:
AI Factory最终不是“需要很多芯片”,而是需要巨大的持续电力。
完整链条:
而未来高密度AI数据中心还可能出现:
HVDC
即:
High Voltage Direct Current,高压直流供电。
十八、电力产业链为什么可能成为最终约束?因为芯片效率提升并不一定意味着:
总电力需求下降。
如果:
那么:
AI Factory总功率仍然可能快速增长。
所以真正应该观察:
单GPU功耗增长速度 × GPU部署规模增长速度
与:
数据中心电力基础设施扩张速度
之间的关系。
如果前者长期超过后者:
Power Wall出现。
十九、六大产业链现在可以形成一个闭环这是最重要的一张图:
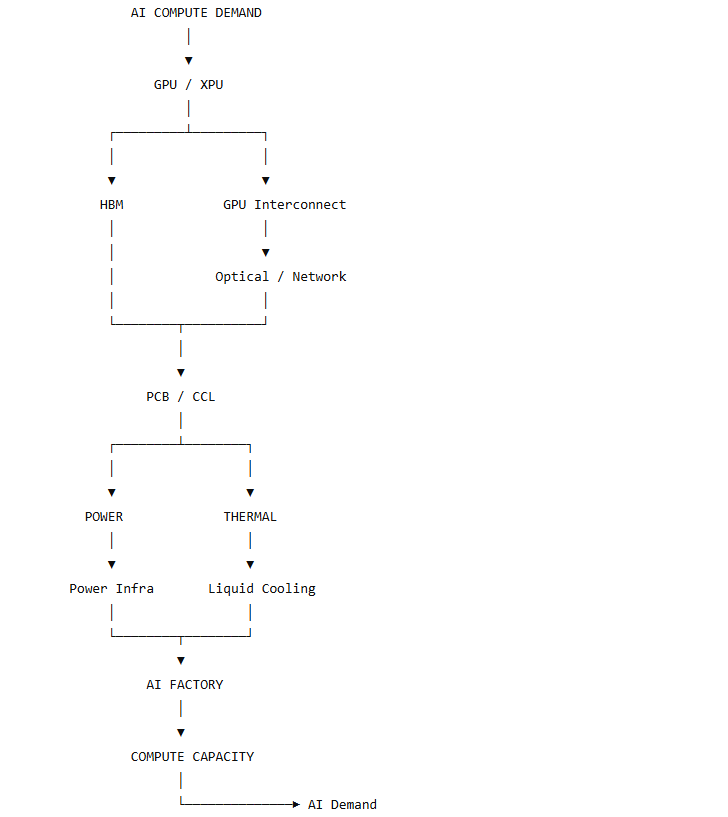
这才是完整的AI产业闭环。
二十、但六条链并不是“同时上涨”这是研究AI产业链最容易出现的误区。
例如:
AI需求增长。
并不意味着:
GPU、HBM、光模块、PCB、液冷、电力同时进入同样强度的景气周期。
因为每个环节的供给弹性不同。
例如:
GPU:
先进制程产能限制。
HBM:
DRAM + TSV + 封装限制。
光通信:
光芯片、Laser、封装、光模块产能限制。
PCB:
CCL、设备、良率限制。
液冷:
系统集成与客户导入限制。
电力:
变压器、并网、配电、基础设施建设周期限制。
所以:
需求是从上游向下游传导,而瓶颈则可能从下游向上游反向反馈。二十一、真正应该建立“六链瓶颈传导矩阵”
可以建立这样的研究框架:
| 产业链需求驱动核心物理约束关键工程变量下一层传导 | ||||
| GPU | AI计算量 | 算力/功耗 | FLOPS、W、I/O | HBM/网络/电力 |
| HBM | GPU带宽 | DRAM+堆叠+封装 | 带宽、层数、容量 | 封装 |
| 光通信 | GPU通信 | 电互连损耗 | SerDes、pJ/bit | CPO/Optical I/O |
| PCB/CCL | 高速电连接 | 高频损耗 | Dk、Df、loss | 光通信 |
| 液冷 | GPU功耗 | 热流密度 | W/cm²、CDU | 数据中心 |
| 电力 | GPU数量×功耗 | 电网/配电 | MW、kW/rack | AI Factory规模 |
这个表比传统的“产业链地图”更重要。
因为它开始回答:
为什么需要它。
二十二、再进一步:六条链实际上对应六种不同的“墙”GPU
Compute Wall
计算能力墙。
HBM
Memory Wall
内存带宽墙。
光通信
Communication Wall
通信墙。
PCB/CCL
Electrical Signal Wall
高速电信号墙。
液冷
Thermal Wall
热墙。
电力
Power Wall
能源墙。
这六堵墙共同决定:
AI Factory到底还能扩张多快。二十三、最关键的是:六堵墙之间存在因果关系
例如GPU升级:
这就是完整的:
AI Factory产业传导链 二十四、反过来,电力也可以向上游反向约束例如:
数据中心获得的电力不足。
那么:
因此:
产业传导并不是单向的。
而是一个:
闭环反馈系统。 二十五、这就是为什么AI产业链不能只研究“需求”真正完整的研究应该同时跟踪:
Demand
需求。
Supply
供给。
Bottleneck
瓶颈。
Substitution
替代。
Transmission
传导。
Pricing
价格。
Capex
资本开支。
Validation
验证。
最终形成:
这才是完整产业周期。
二十六、从投资研究角度,最重要的不是“六链都买”六条产业链同时存在:
并不意味着六条链同时具有同样的资产机会。
真正需要寻找的是:
当前哪个瓶颈最紧?
以及:
市场是否已经充分定价这个瓶颈?
例如:
产业状态改善
真实物理瓶颈出现
供给短期无法快速增加
价格尚未充分反映
这才形成真正值得进一步研究的资产机会。
反过来:
如果:
产业逻辑很好
但:
产能已经快速释放
价格已经充分反映
那么产业逻辑正确:
不等于资产还有同样的机会。
二十七、因此六链应该建立三层跟踪体系第一层:产业状态
回答:
AI Factory是否继续扩张?
跟踪:
- GPU部署
- AI服务器
- 数据中心CapEx
- 集群规模
- 网络带宽
- 电力建设
第二层:瓶颈状态
回答:
现在最紧的是什么?
例如:
GPU供给紧?
HBM紧?
先进封装紧?
SerDes紧?
光模块紧?
CCL紧?
液冷紧?
变压器紧?
第三层:资产表达
回答:
市场最终选择了谁?
这时候才进入:
- 龙头股
- 核心供应商
- 海外映射
- 国内映射
- 估值
- 价格趋势
- 相对强弱
这三个层次不能混。
二十八、六链研究最终应该形成一个“瓶颈状态机”例如:
对应产业:
每一个环节都可以独立处于不同阶段。
所以可能出现:
这才是真实的AI Factory。
而不是简单一句:
“AI产业景气。”
二十九、进一步形成“六链温差”这和传统产业研究最大的不同就在这里。
假设:
那么真正值得研究的不是:
AI需求增长20%。
而是:
为什么不同产业链的景气斜率出现巨大差异?
这个差异本身就是:
产业温差。而产业温差背后往往对应:
瓶颈迁移。
三十、六链最终会形成一个动态传导网络最终不是:
六个孤立节点。
而是:
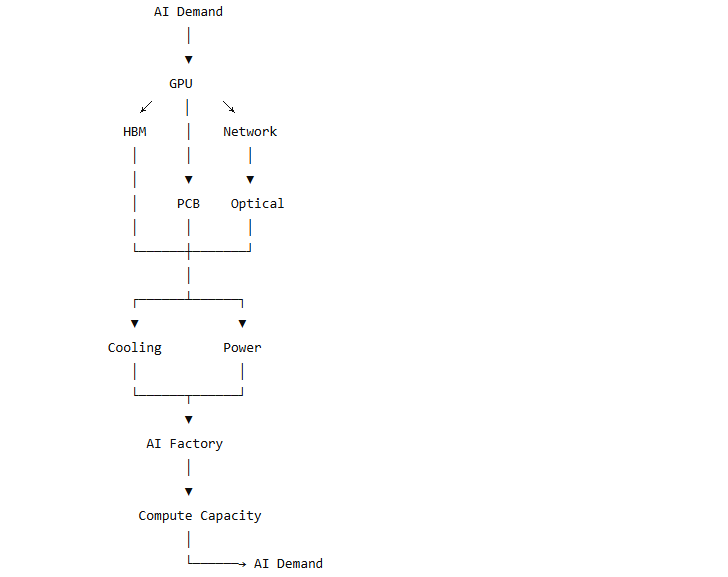
这已经非常接近一个:
AI Factory产业世界模型。三十一、最终形成产棱真正应该跟踪的六链核心变量
如果把整个体系进一步压缩,每天真正需要观察的不是几百个指标,而是几个关键状态。
GPU
Compute Capacity
当前可部署计算能力。
HBM
Memory Bandwidth / Capacity
计算是否受到内存约束。
Optical
Communication Bandwidth / Electrical Reach
通信是否开始成为约束。
PCB/CCL
Electrical Signal Integrity
高速电连接是否开始出现硬约束。
Liquid Cooling
Rack Thermal Density
单机柜热密度是否继续上升。
Power
Available MW / Rack Power
AI Factory能否获得足够电力。
最终可以浓缩成:
而这六个东西共同决定:
AI Factory的可计算能力。 三十二、真正的核心:寻找下一堵墙因此未来研究AI Factory,不应该每天问:
“今天哪个AI板块涨得最多?”
而应该首先问:
AI计算规模继续扩大以后,下一堵不可绕开的物理墙在哪里?
然后继续追:
这才是六大产业链真正应该形成的动态研究框架。
三十三、最终的AI Factory六链总图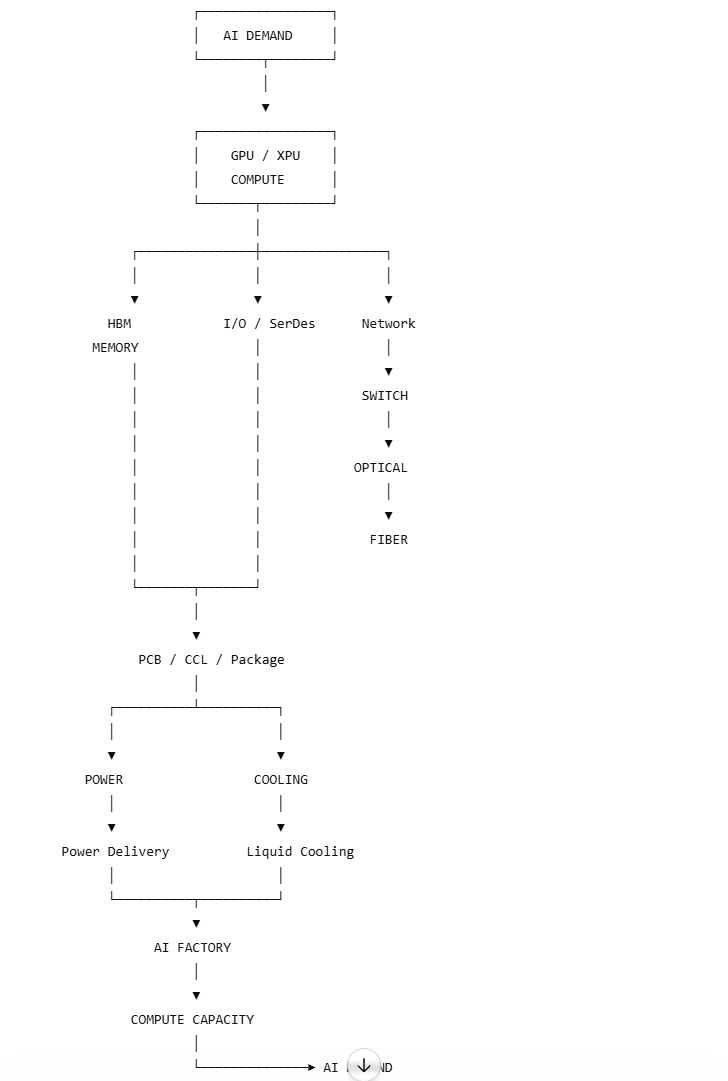
AI Factory的六大产业链,本质上并不是六个行业。
而是六个物理层:
GPU解决“算”。
HBM解决“供数据”。
光通信解决“远距离高速传数据”。
PCB/CCL解决“电信号怎么可靠跑”。
液冷解决“热怎么带走”。
电力解决“整个系统怎么获得足够能量”。
它们共同构成:
AI计算基础设施的六个基本物理约束。而整个产业周期真正的核心,就是:
约束在哪里,瓶颈就在哪里;瓶颈在哪里,资本开支就会向哪里移动;资本开支向哪里移动,产业价值就会向哪里重新分配。
所以,未来真正值得建立的不是一张静态的“AI产业链图”。
而是一张:
AI Factory Bottleneck Transmission MapAI Factory瓶颈传导地图
它应该能够持续回答四个问题:
① 当前AI Factory最大的约束是什么?
② 这个约束正在变紧还是变松?
③ 这个约束正在把需求和资本开支传导到哪个产业节点?
④ 当这个约束解除以后,下一堵墙会移动到哪里?
这四个问题一旦能够持续、动态地回答,GPU、HBM、光通信、PCB/CCL、液冷、电力就不再是六个独立的研究赛道,而会真正变成一个可以计算、跟踪和验证的 AI Factory产业系统。