产棱 · 技术拆解 09 | NVLink 6 深度拆解
本文 24 节
- 核心问题
- 先给结论
- 一、为什么 AI 越发展,GPU 之间的通信越重要?
- 二、NVLink到底是什么?先把“链路”拆开
- 三、为什么 NVLink 6 要做到 3.6TB/s?
- 四、NVSwitch:为什么没有交换芯片,72颗GPU无法真正成为一个整体?
- 五、为什么 NVL72 的关键不是72,而是“全互联”?
- 六、NVLink真正的工程难点:带宽越高,物理世界越难
- 七、为什么 NVLink 会把压力传导到 PCB 与连接器?
- 八、为什么 NVLink 6 会推动“高速PCB”升级?
- 九、NVLink与NVSwitch为什么必须一起设计?
- 十、NVLink 6为什么会成为“系统价值放大器”?
- 十一、NVLink真正的瓶颈在哪里?
- 十二、为什么“理论带宽”不等于“有效算力”?
- 十三、从 NVLink 到 NVL72:通信开始进入“整机柜价值池”
- 十四、为什么 NVLink 是“AI硬件产业链”的一个关键分水岭?
- 十五、NVLink与CPO/光通信的关系:为什么最终会走向更高带宽?
- 十六、NVLink的产业价值如何进入产棱“瓶颈池”?
- 十七、为什么“NVLink涨价”不是最值得看的指标?
- 十八、从72颗GPU到下一代AI系统:通信的边界在哪里?
- 十九、产棱持续跟踪:NVLink应该看什么?
- 二十、最终拆解:NVLink到底改变了什么?
- 产棱最终判断
- 附录|关键数据与来源
NVLink 6 拆解:为什么72颗GPU必须像一颗芯片一样通信?
从 GPU 内部互连 → NVLink → NVSwitch → NVL72 → 集群通信,拆解 AI 算力从“计算能力”走向“通信能力”的系统性变化。
核心问题
当模型规模不断扩大,单颗 GPU 的算力已经不是唯一约束。真正决定 72 颗 GPU 能否作为一个整体工作的,是 GPU 之间能否以足够高的带宽、足够低的延迟、足够稳定的拓扑完成持续通信。NVLink 6 的价值,正是在这里发生。
先给结论
- NVLink 已经不是传统意义上的“高速接口”,而是 NVL72 的核心计算基础设施。
- NVIDIA 官方披露,NVLink 6 为每颗 Rubin GPU 提供最高 3.6TB/s 带宽,NVL72 形成 72-GPU 全互联网络,总带宽达到 260TB/s。
- NVSwitch 的意义不是简单“扩口”,而是把原本局部的 GPU-to-GPU 连接扩展成机柜级 all-to-all 非阻塞通信域。
- 因此,GPU 越多,系统价值越从“GPU芯片”向交换芯片、连接器、高速PCB/背板、信号完整性、电源完整性、散热与软件通信栈传导。
- 产棱核心判断:AI 集群的下一层瓶颈,不再只是“算力够不够”,而是“算力能不能被通信网络真正组织起来”。
图1|从单颗GPU到NVL72:NVLink把多个GPU组织成一个通信域
一、为什么 AI 越发展,GPU 之间的通信越重要?
传统 GPU 服务器的思路是:GPU 是计算器,PCIe 是外部总线,网络负责服务器之间通信。但大模型训练与推理逐渐改变了这个假设。模型参数、激活值、KV Cache、专家路由和集体通信操作越来越多地跨 GPU 发生。
对于 MoE、长上下文、test-time reasoning 等工作负载,GPU 不只是各自计算,还必须持续交换数据。如果计算速度提高,而通信速度没有同步提升,GPU 就会出现“等数据”的空转。于是,通信网络从外围设备变成了计算系统的一部分。
| 工作负载 | 通信需求 | 为什么需要高带宽 |
| 模型并行 | GPU之间频繁交换张量 | 计算被通信直接串联 |
| 数据并行 | 梯度/参数聚合 | AllReduce产生大规模数据交换 |
| MoE | Token在专家之间路由 | 通信量随专家数量和Token规模增长 |
| 长上下文推理 | KV Cache与中间状态增长 | 显存与GPU间数据移动增加 |
| Test-time reasoning | 推理步骤增加 | 单位请求通信次数与数据量提高 |
二、NVLink到底是什么?先把“链路”拆开
NVLink最容易被误解成一根“更快的线”。但从系统角度,它至少包含四层:物理高速链路、GPU内部接口、NVLink Switch交换结构,以及由软件/通信库调度的集体通信。真正的价值来自四层共同工作。
图2|NVLink不是单一器件,而是一套从物理链路到通信软件的系统
| 层级 | 核心对象 | 主要解决的问题 | 价值 |
| 物理层 | 高速SerDes/封装/连接 | 信号能否可靠跑到目标速率 | 决定带宽上限 |
| 链路层 | NVLink协议与GPU接口 | 如何可靠传输数据 | 决定效率与延迟 |
| 交换层 | NVSwitch | 如何把72颗GPU组织起来 | 决定系统拓扑 |
| 软件层 | 通信库/Collective | 如何调度AllReduce等操作 | 决定实际利用率 |
三、为什么 NVLink 6 要做到 3.6TB/s?
NVIDIA 官方给出的 NVLink 6 单 GPU 带宽为 3.6TB/s,是上一代 1.8TB/s 的 2 倍,也是 PCIe Gen6 的 14 倍以上。 这个数字真正重要的地方,不是“接口速度很快”,而是它开始接近 GPU 内部存储系统与计算系统的数量级。
| 指标 | NVLink 5 | NVLink 6 | 变化 |
| 单GPU带宽 | 1.8TB/s | 3.6TB/s | 2× |
| NVL72总带宽 | 130TB/s | 260TB/s | 2× |
| GPU域规模 | 最高72 | 72 | 维持机柜级 |
| 单GPU链路数 | 18 | 36 | 2× |
这意味着系统设计已经从“让几个GPU互通”进入“让几十颗GPU形成统一通信域”。当GPU数量增加时,通信网络必须同步扩张,否则新增GPU并不会线性增加有效算力。
四、NVSwitch:为什么没有交换芯片,72颗GPU无法真正成为一个整体?
如果只把GPU两两连接,随着GPU数量增加,链路数量和布线复杂度会迅速失控。NVSwitch承担的是网络拓扑中的“集中交换”功能:它让来自不同GPU的NVLink连接能够被重新组织,并提供跨节点的高速all-to-all通信。NVIDIA明确将NVLink Switch描述为连接多个NVLink、实现整个机柜GPU all-to-all通信的交换芯片。
因此,NVSwitch的价值不是“芯片价格”,而是它承担了整个机柜通信架构的组织功能。
五、为什么 NVL72 的关键不是72,而是“全互联”?
72颗GPU并不天然等于72颗GPU的有效算力。关键在于任意GPU之间能否以稳定的高带宽进行通信。NVIDIA公开资料显示,Vera Rubin NVL72采用72 GPU all-to-all拓扑,整体NVLink带宽达到260TB/s。
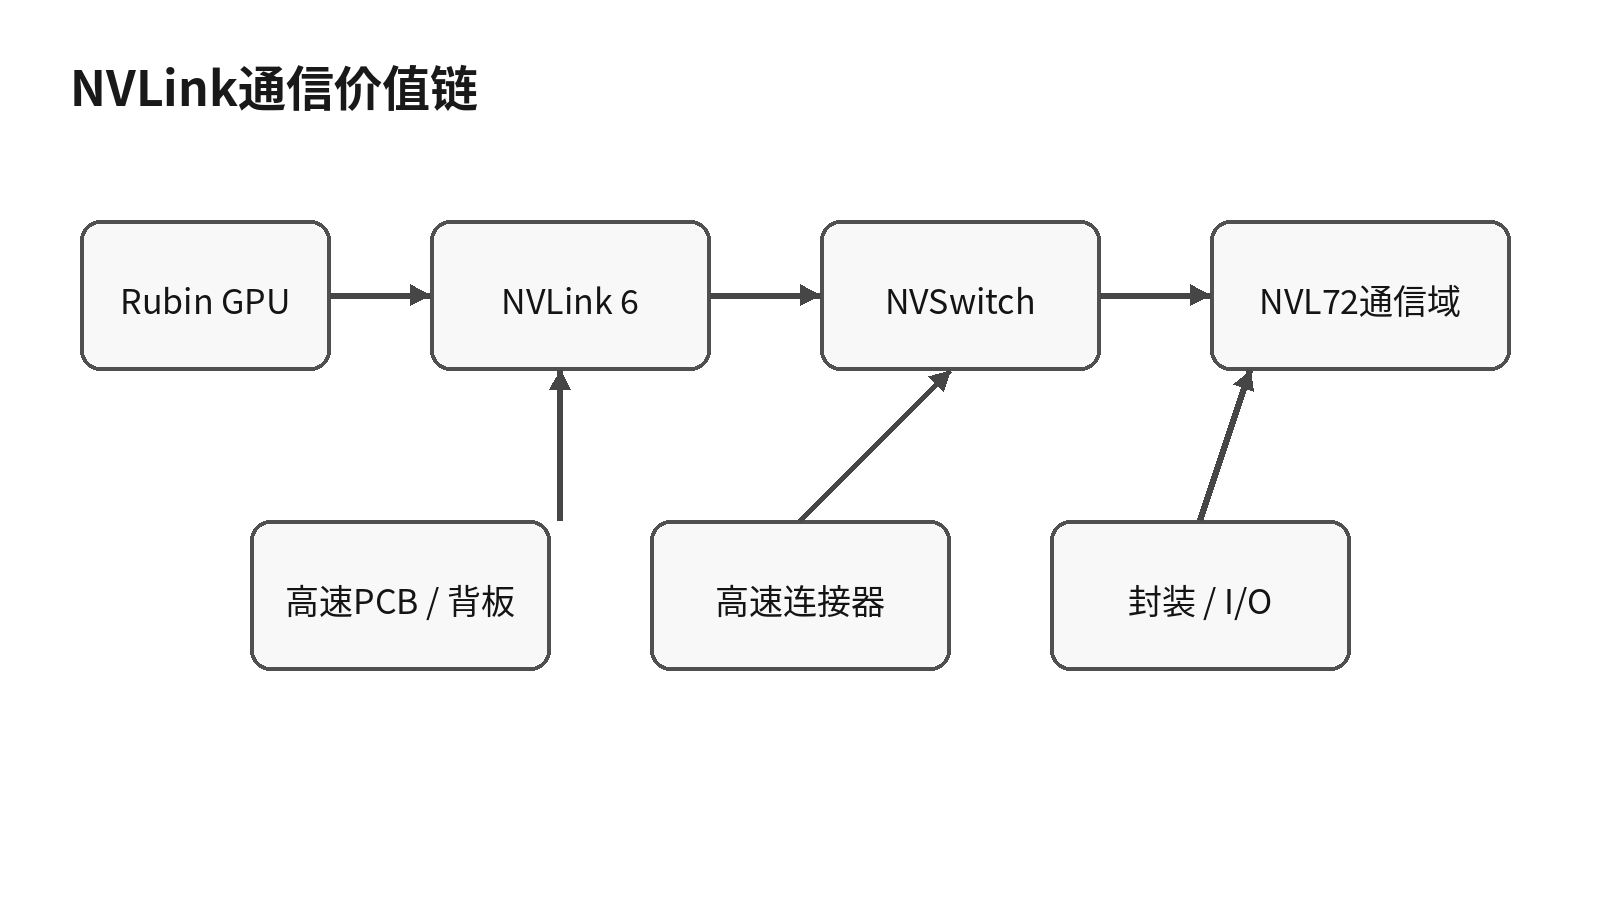
图3|通信能力从GPU接口向交换芯片、连接、PCB与系统软件逐层传导
“全互联”带来的核心变化是:GPU不再被看成72个独立计算节点,而更接近一个大型共享计算资源池。对于需要频繁跨GPU同步的模型,这种架构可以显著减少通信成为系统瓶颈的概率。
六、NVLink真正的工程难点:带宽越高,物理世界越难
当链路速率不断提高,问题会从“有没有通道”转向“信号能否完整到达”。高速SerDes会受到插损、回损、串扰、抖动、封装寄生参数、连接器损耗、PCB走线以及电源噪声影响。于是NVLink的性能提升会直接向封装、PCB、连接器、材料和测试传导。
| 工程变量 | 问题 | 产业传导 |
| Insertion Loss | 高频信号在通道中衰减 | 低损耗材料/PCB |
| Return Loss | 阻抗不连续导致反射 | 连接器/过孔/布线设计 |
| Crosstalk | 相邻高速通道互相干扰 | 线距/层叠/材料 |
| Jitter | 时钟与数据边沿不稳定 | SerDes/时钟/电源 |
| Power Integrity | 电源噪声影响高速I/O | MLCC/PDN/VRM |
| Thermal | 高速器件功耗增加 | 散热/液冷/结构设计 |
七、为什么 NVLink 会把压力传导到 PCB 与连接器?
当每颗GPU拥有36条NVLink连接时,系统中的高速通道数量已经达到机柜级规模。通道越多,任何单条链路的损耗、串扰或阻抗异常都可能降低系统稳定性。于是PCB不再只是“承载芯片的板”,而成为通信通道本身。
这也是为什么在VR200这类系统中,PCB价值虽然相对GPU很小,但其工程重要性远高于BOM占比。对产棱而言,这类“低金额、高系统权重”的环节尤其值得进入瓶颈池。
八、为什么 NVLink 6 会推动“高速PCB”升级?
高速通信要求更严格的介质损耗、铜粗糙度、线宽线距、层间对准、背钻、过孔结构和阻抗控制。PCB的价值由“面积”逐渐转向“单位面积可承载多少高速通道”。
| 维度 | 普通PCB思路 | AI高速通信PCB思路 |
| 核心指标 | 板面积、层数 | 损耗、阻抗、串扰、通道密度 |
| 材料 | 通用FR-4等 | 低Dk/低Df高速材料 |
| 制造 | 常规钻孔/线路 | 激光/背钻/精细线路 |
| 良率 | 板级合格率 | 高速通道级可靠性 |
| 价值来源 | 面积×层数 | 高速通道密度×可靠性 |
九、NVLink与NVSwitch为什么必须一起设计?
如果GPU接口、交换芯片、PCB、连接器分别优化,最终系统很难获得最优结果。NVLink本质上要求GPU、NVSwitch、封装、板级互连和软件共同设计。NVIDIA对Rubin平台的描述本身就是“深度协同设计”的思路:计算、互连、交换与软件共同构成系统。
这意味着NVLink的竞争壁垒并不只是一颗交换芯片,而是整个scale-up fabric。
十、NVLink 6为什么会成为“系统价值放大器”?
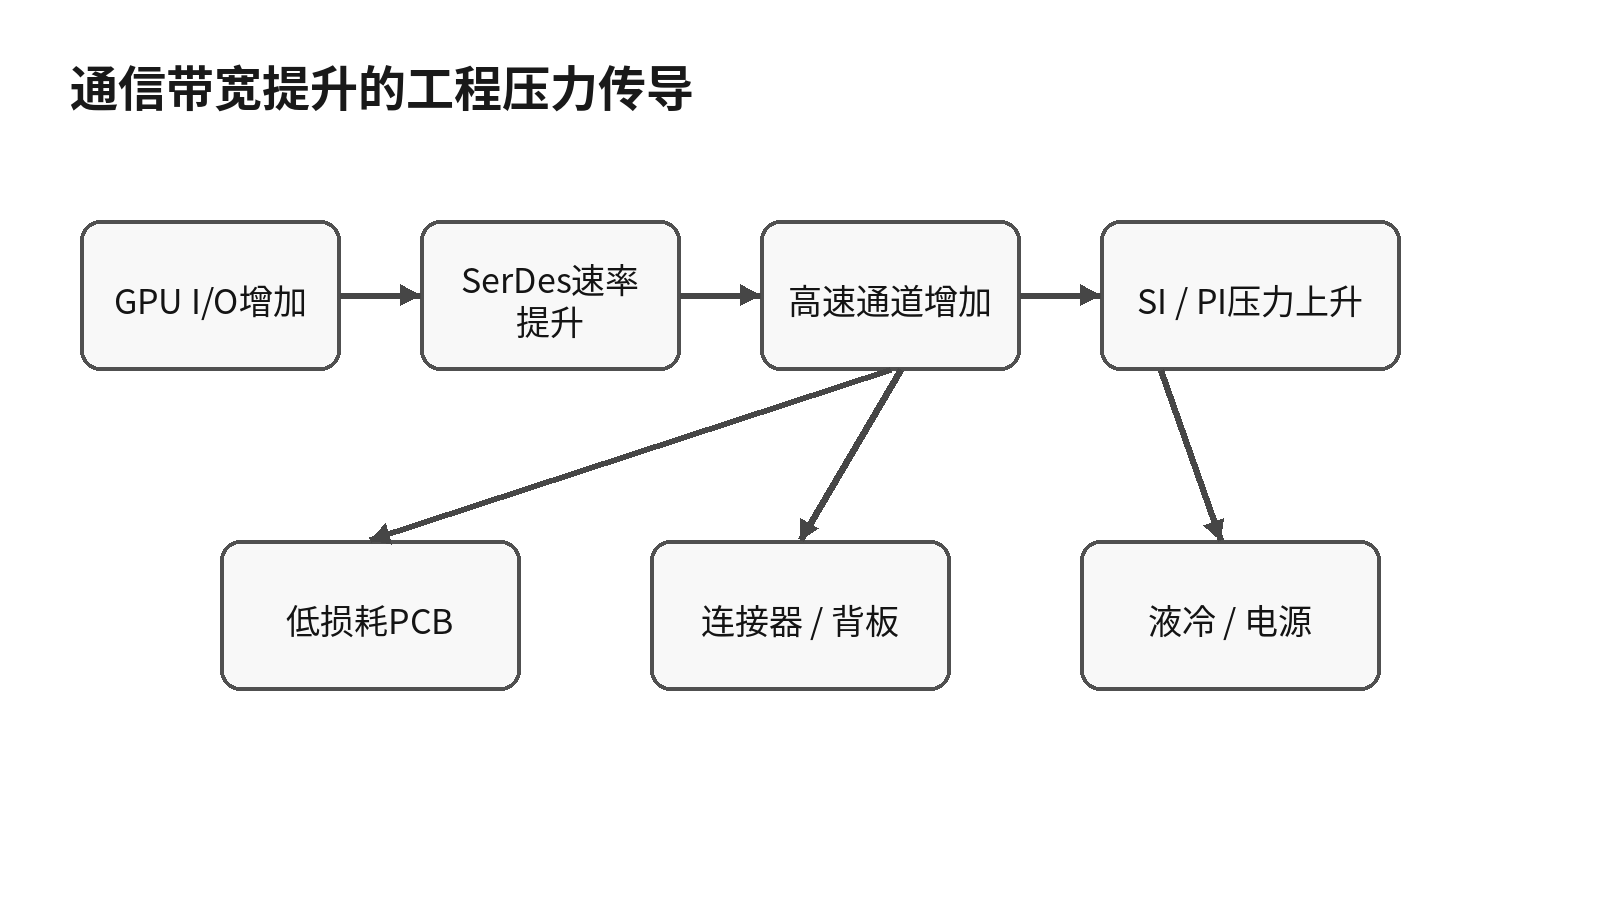
图4|NVLink性能提升如何逐层传导至封装、PCB、连接器、交换芯片与散热
当单GPU通信带宽从1.8TB/s提升到3.6TB/s时,最直接的变化是通信能力翻倍;但产业链承受的不是一个“2倍”的单变量,而是一组耦合压力:高速I/O数量增加、SerDes能力提升、交换能力提升、PCB高速通道密度增加、连接器性能提高、功耗与散热压力增加。
十一、NVLink真正的瓶颈在哪里?
不能简单把瓶颈定义成“NVLink芯片产能”。更合理的方式,是把瓶颈拆成四层:
| 瓶颈层 | 核心变量 | 产棱关注点 |
| 芯片层 | NVLink/NVSwitch芯片复杂度 | 先进制程、I/O、封装、良率 |
| 互连层 | 高速PCB/连接器/背板 | 损耗、串扰、通道密度、良率 |
| 系统层 | 拓扑、功耗、散热、可靠性 | 整机柜稳定运行能力 |
| 软件层 | Collective通信效率 | 硬件带宽能否转化为有效吞吐 |
十二、为什么“理论带宽”不等于“有效算力”?
3.6TB/s是物理层能力,但实际AI任务的性能取决于通信模式、消息大小、拓扑、并发度、同步频率、软件调度和计算/通信重叠程度。也就是说,真正需要跟踪的变量不是“NVLink规格”本身,而是“有效通信利用率”。
这与产棱此前对HBM的判断类似:HBM的TB/s不是最终价值,真正重要的是它能否转化为模型吞吐;NVLink同样如此。
十三、从 NVLink 到 NVL72:通信开始进入“整机柜价值池”
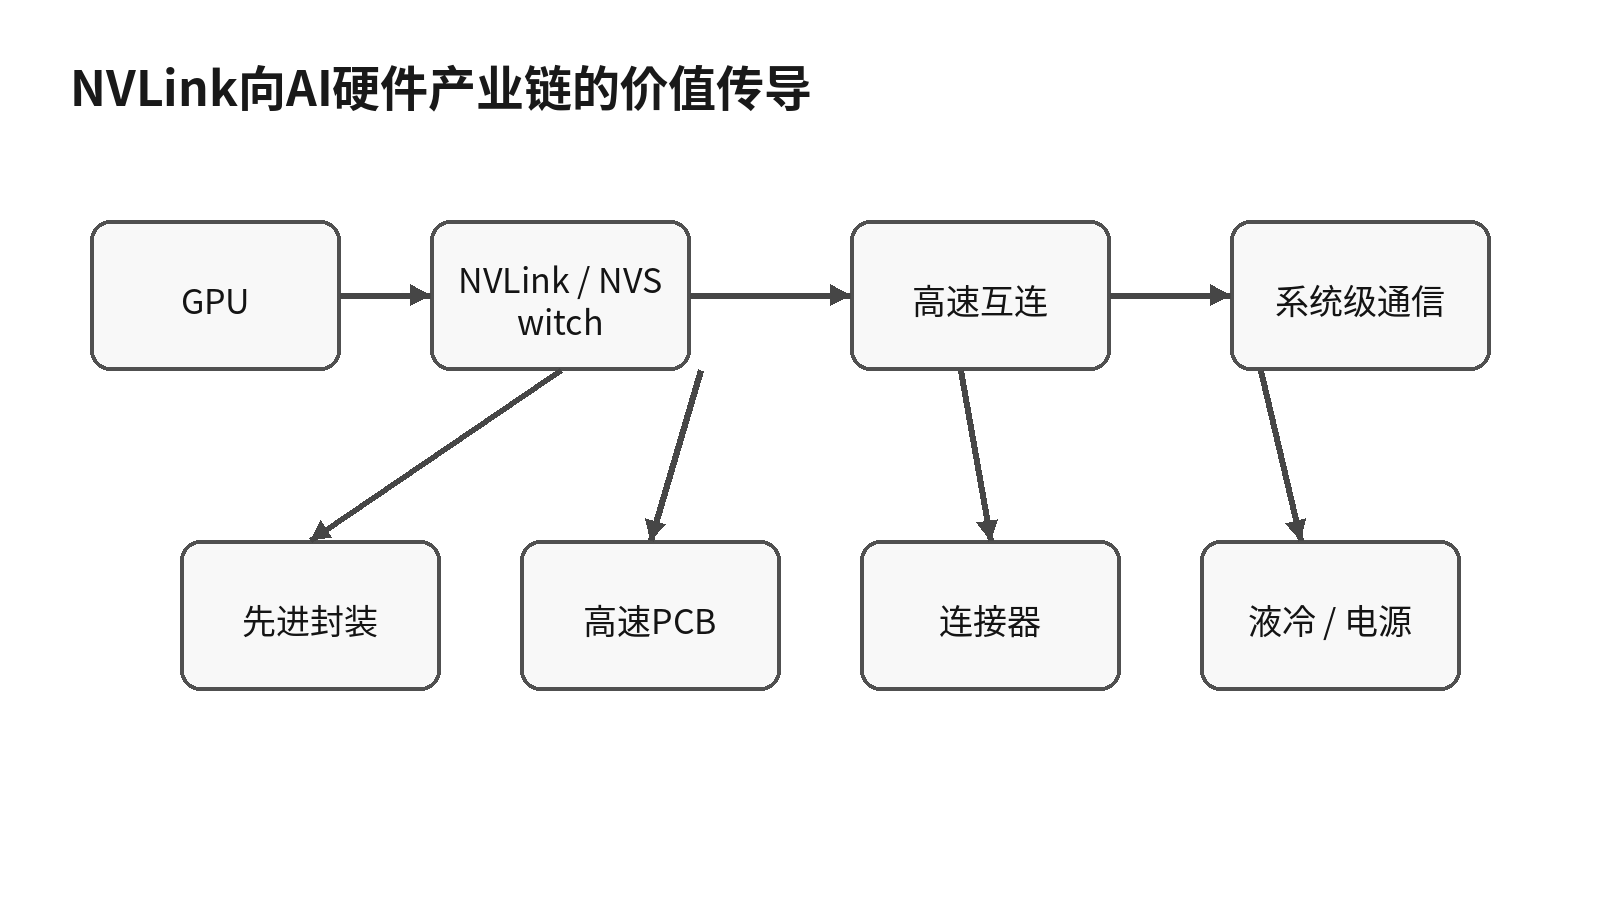
图5|NVLink从技术能力向产业价值池传导的路径
NVLink带来的产业价值并不是集中在一个环节,而是沿着“GPU I/O → NVSwitch → 高速互连 → PCB/背板 → 电源 → 液冷 → 软件通信”逐层扩散。
| 价值池 | 为什么受益 | 产棱观察变量 |
| NVSwitch | 机柜级all-to-all核心 | 芯片数量、带宽、拓扑 |
| 高速PCB/背板 | 承载高速通道 | 层数、材料、损耗、良率 |
| 连接器 | 决定物理通道质量 | 高速规格、插损、可靠性 |
| 先进封装 | 高密度I/O集成 | 封装尺寸、I/O数量、良率 |
| 液冷/电源 | 通信与计算功耗上升 | 机柜功率、热密度 |
| 软件通信栈 | 把硬件带宽变成有效吞吐 | Collective效率、通信占比 |
十四、为什么 NVLink 是“AI硬件产业链”的一个关键分水岭?
过去市场容易把AI硬件理解为GPU产业链。但当单机柜进入几十颗GPU、数百TB/s级通信后,GPU之间的通信已经成为独立的产业链。此时,GPU、HBM、先进封装、NVSwitch、高速PCB、连接器、液冷、电源不再是彼此孤立的零部件,而是同一个系统工程。
产棱核心判断:AI硬件的价值迁移正在从“单芯片价值”走向“系统互连价值”。NVLink正是观察这一迁移最好的技术窗口之一。
十五、NVLink与CPO/光通信的关系:为什么最终会走向更高带宽?
当scale-up网络持续扩大,铜互连会逐渐面临距离、功耗和信号完整性的约束。这里不能简单得出“NVLink一定转光”的结论,但可以确定:随着AI系统带宽密度持续提高,光电融合、CPO、硅光等技术会成为值得持续跟踪的潜在路径。
这也是为什么NVLink拆解不能孤立于光通信链。通信带宽越往上走,互连材料与物理介质本身的重要性越高。
十六、NVLink的产业价值如何进入产棱“瓶颈池”?
| 跟踪变量 | 当前意义 | 异常信号 |
| 单GPU NVLink带宽 | 决定scale-up能力 | 新一代带宽跃升 |
| NVSwitch带宽/端口密度 | 决定机柜拓扑 | 交换能力成为约束 |
| 高速PCB层数/材料 | 承载更多高速通道 | 高端产能紧张 |
| 连接器规格 | 物理通道瓶颈 | 高速连接器升级 |
| 封装I/O密度 | 决定芯片与系统之间的连接能力 | I/O密度快速上升 |
| 机柜功耗 | 通信+计算共同推高 | 液冷/电源升级 |
| 通信利用率 | 决定理论带宽能否兑现 | 软件成为新瓶颈 |
十七、为什么“NVLink涨价”不是最值得看的指标?
对于产业研究而言,真正值得观察的是NVLink带来的系统价值,而不是某一颗交换芯片的价格。一个零部件即使在BOM中占比很小,只要它决定整个系统的通信能力,就可能拥有远高于自身金额的战略价值。
因此,产棱不把NVLink简单定义为“网络芯片”,而把它定义为:AI机柜从计算资源向计算网络转变的关键基础设施。
十八、从72颗GPU到下一代AI系统:通信的边界在哪里?
NVL72说明了一条非常清晰的产业路径:GPU数量增加 → 通信带宽增加 → 交换能力增加 → 高速互连密度增加 → PCB/连接器/封装升级 → 功耗与散热增加。
下一阶段真正值得观察的,不是“还能塞多少GPU”,而是:在更大模型、更长上下文、更高推理密度下,系统是否仍能保持计算与通信之间的平衡。
十九、产棱持续跟踪:NVLink应该看什么?
- GPU数量:8 → 72 → 更大规模,观察通信域如何扩张。
- 单GPU带宽:观察每代NVLink升级幅度。
- 交换芯片:观察NVSwitch端口、带宽、拓扑变化。
- 高速PCB:观察材料、层数、通道密度与高端产能。
- 连接器/背板:观察高速规格与可靠性要求。
- 封装I/O:观察GPU封装向更高I/O密度演进。
- 功耗与液冷:观察通信能力提升带来的系统功耗增量。
- 软件利用率:观察理论带宽向有效模型吞吐的转化。
二十、最终拆解:NVLink到底改变了什么?
第一,NVLink把GPU之间的通信从“外围接口”提升为AI计算系统的一部分。
第二,NVSwitch把几十颗GPU组织成一个高带宽、all-to-all的计算域,使机柜开始表现得更像一个大型加速器。
第三,通信能力的提升不会只增加网络芯片价值,而会向先进封装、高速PCB、连接器、电源、液冷和软件通信栈同步传导。
第四,理论带宽并不是终点。真正决定系统价值的是有效通信能力,即硬件带宽能否被模型和软件持续利用。
第五,随着AI系统规模继续扩大,通信本身正在从“GPU的配套能力”演变为独立的产业价值池。
产棱最终判断
NVLink 6真正值得研究的,不是3.6TB/s这个数字,而是它背后的产业逻辑:当AI模型规模继续扩大,计算能力最终必须通过高速互连被组织起来。GPU越多,通信越接近计算本身;通信越重要,产业价值就越从单颗GPU向交换芯片、先进封装、高速PCB、连接器、液冷、电源以及软件通信栈扩散。NVL72不是“72颗GPU装在一起”,而是一次把GPU变成一个通信系统的架构升级。
附录|关键数据与来源
| 数据 | 数值 | 来源 |
| NVLink 6 单GPU带宽 | 3.6TB/s | NVIDIA官方 |
| NVLink 5 单GPU带宽 | 1.8TB/s | NVIDIA官方 |
| NVL72 GPU数量 | 72 | NVIDIA官方 |
| NVL72总NVLink带宽 | 260TB/s | NVIDIA官方 |
| NVLink 6最大链路数/GPU | 36 | NVIDIA官方 |
| NVL72拓扑 | all-to-all / non-blocking | NVIDIA官方 |
主要资料:NVIDIA NVLink & NVLink Switch 官方资料;NVIDIA Vera Rubin NVL72官方资料;NVIDIA Rubin平台技术资料。本文中的产业链传导与瓶颈判断属于产棱研究框架,不等同于厂商官方表述。
研究边界:本文重点研究NVLink作为AI scale-up互连基础设施的工程与产业价值,不对具体上市公司进行投资评级,也不将理论带宽直接等同于实际模型性能。