产棱 · 技术拆解10|NVSwitch深度拆解
本文 21 节
- 一、先给结论:NVSwitch不是“网络配件”,而是72 GPU成为一个计算域的交换中枢
- 二、为什么GPU数量一上去,“怎么通信”会成为核心问题
- 三、第一层:NVLink到底负责什么?
- 四、第二层:NVSwitch究竟在交换什么?
- 五、第三层:为什么不用GPU直接两两连接?
- 六、第四层:真正重要的不是“交换”,而是“全互联”
- 七、第五层:带宽只是第一变量,延迟才决定通信效率
- 八、第六层:为什么NVSwitch本身也越来越像一颗“网络GPU”
- 九、第七层:NVSwitch为什么会把压力传给PCB与连接器?
- 十、第八层:为什么MoE会进一步提高NVSwitch的价值
- 十一、第九层:NVSwitch的功耗为什么值得关注
- 十二、第十层:NVSwitch为什么开始进入“可维护性”设计
- 十三、把NVSwitch放回NVL72:它到底处于什么位置?
- 十四、NVSwitch真正的产业价值:不是一颗芯片,而是一整套“高速通信约束”
- 十五、NVSwitch是不是新的产业瓶颈?
- 十六、一个容易被忽视的变化:AI服务器正在从“服务器”变成“GPU网络”
- 十七、产棱如何持续跟踪NVSwitch
- 十八、NVSwitch价格 ≠ NVSwitch产业价值
- 十九、产棱最终拆解:为什么72颗GPU背后必须有一个“交换大脑”
- 二十、研究边界与来源
- 产棱 · 技术拆解10|NVSwitch
核心问题:NVLink已经把GPU连起来,为什么还需要NVSwitch?
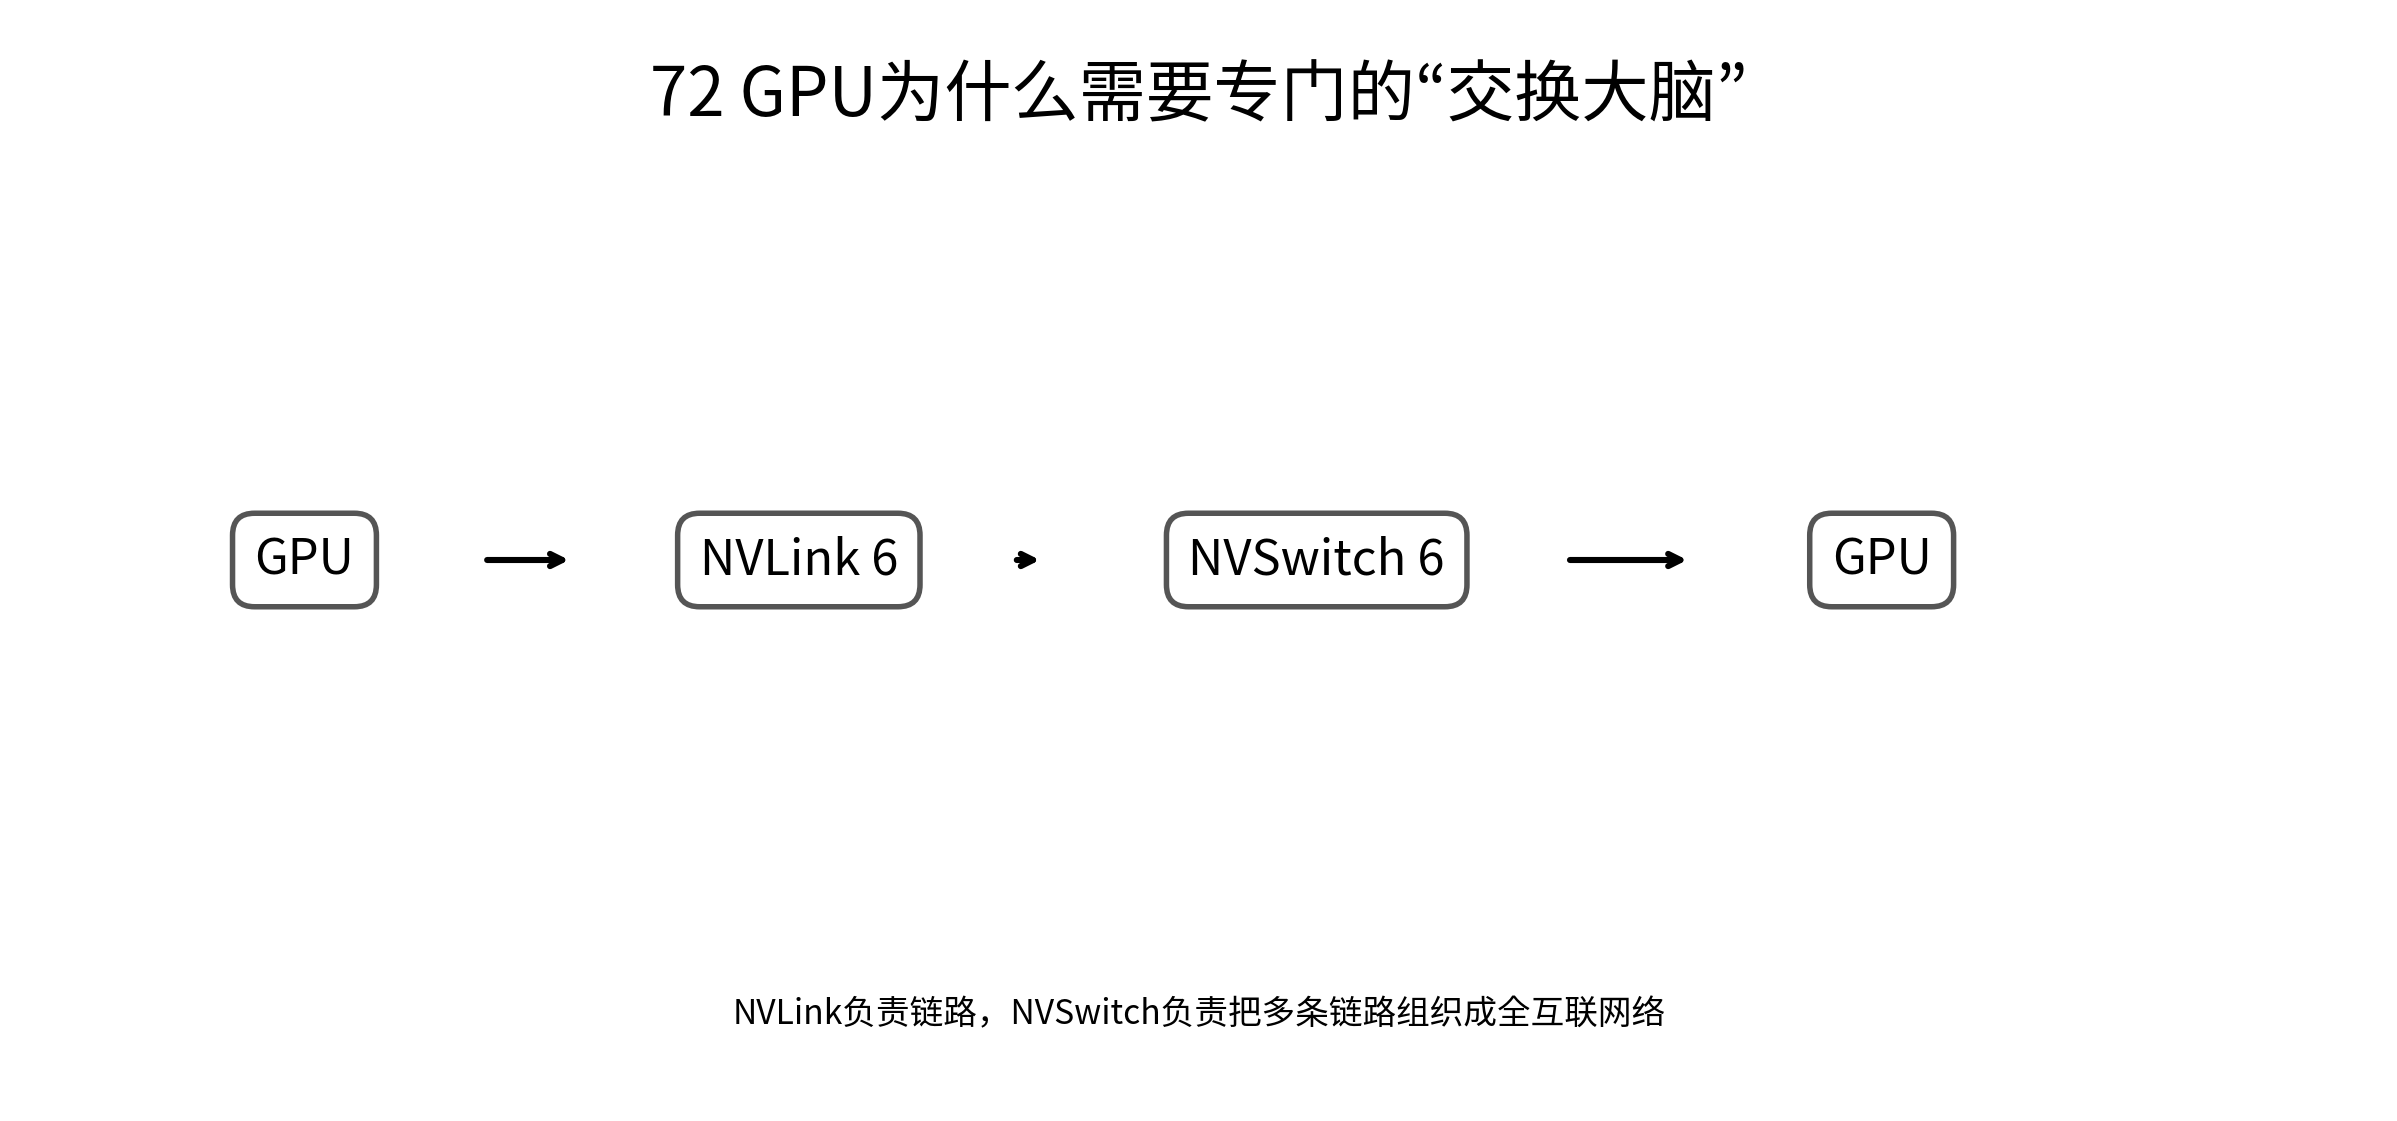
图1|NVLink负责高速链路,NVSwitch负责把大量链路组织成可扩展的全互联Fabric。
一、先给结论:NVSwitch不是“网络配件”,而是72 GPU成为一个计算域的交换中枢
如果只把NVSwitch理解成“一个更快的交换芯片”,就低估了它在NVL72中的位置。真正的问题是:当GPU数量从8颗扩展到72颗以后,GPU之间的通信关系会从少量点对点连接,变成一个需要大规模调度、聚合、路由和故障管理的通信网络。
NVLink 6解决的是“单条高速GPU互连”的能力;NVSwitch解决的是“很多条NVLink如何形成一个统一的GPU通信Fabric”。NVIDIA公开资料显示,Rubin平台每颗GPU提供最高3.6 TB/s双向NVLink带宽,Vera Rubin NVL72通过NVLink 6 Switch形成72 GPU全互联拓扑,总聚合带宽达到260 TB/s。citeturn0search1turn0search2
因此,NVSwitch真正创造的系统价值不是“增加带宽”这么简单,而是把72颗GPU从一组服务器里的独立加速器,组织成一个具有统一通信特征的巨大计算域。
二、为什么GPU数量一上去,“怎么通信”会成为核心问题
AI模型的计算并不是GPU各算各的。张量并行、专家并行、数据并行以及各种collective operation都会产生GPU之间的数据交换。模型越大、并行度越高,通信在总执行时间中的权重越高。NVIDIA也将NVLink定位为面向AI训练和推理的scale-up fabric。citeturn0search0turn0search1
| 规模 | 核心问题 | 通信结构压力 |
| 少量GPU | GPU之间直接连接 | 链路数量尚可管理 |
| 几十颗GPU | 跨板卡通信增加 | 需要更系统的交换 |
| 72 GPU | 任意GPU之间都可能通信 | 必须形成全互联Fabric |
| 更大规模 | 跨机架/跨域通信 | scale-up与scale-out边界开始变化 |
三、第一层:NVLink到底负责什么?
NVLink可以理解为GPU的“高速公路”。它定义了GPU之间的数据传输通道、链路带宽以及物理/协议层面的通信能力。第9篇已经拆过NVLink 6,因此本篇重点不是重复链路,而是回答:这些高速链路接下来如何被组织起来。
| 指标 | NVLink 6公开规格 | 产业意义 |
| 单GPU带宽 | 3.6 TB/s | 决定GPU与GPU之间的高速通信上限 |
| GPU最大Link数 | 36 | 决定单GPU可接入Fabric的链路规模 |
| NVL72总聚合带宽 | 260 TB/s | 形成机架级通信能力 |
| 拓扑 | 72 GPU all-to-all | 降低GPU间通信的拓扑差异 |
这里最重要的是“all-to-all”。它意味着系统设计目标不是让某几个GPU特别快,而是让GPU之间形成一致、可预测的通信关系。NVIDIA称NVLink Switch可以把多个NVLink连接起来,实现整个机架的all-to-all GPU通信。citeturn0search1
四、第二层:NVSwitch究竟在交换什么?
NVSwitch本质上是高速NVLink交换芯片。它接收来自不同GPU的NVLink流量,并根据通信目标把数据送往相应路径。它不是传统数据中心网络里的普通Ethernet switch,因为它面对的是GPU之间极高频、极高带宽、低延迟的内部通信。
早期NVSwitch技术资料已经明确采用non-blocking crossbar思路:交换内部不同端口可以同时通信。到了NVLink 6时代,交换能力进一步扩展到机架级GPU Fabric。历史结构可以帮助理解今天的设计逻辑,但具体端口数量和实现应以对应代际规格为准。citeturn0search13
五、第三层:为什么不用GPU直接两两连接?
如果N颗GPU完全点对点连接,理论上的链路数量会随N²增长。72颗GPU的两两组合为2556对。虽然实际系统并不采用这种简单的物理全网状布线,但这个数量级足以说明:直接靠GPU彼此拉线会迅速进入不可管理区。
NVSwitch的价值就在这里:把大量GPU端口集中到交换结构中。GPU只需要接入Fabric,而不是为每一个潜在通信对象建立一条独立物理链路。
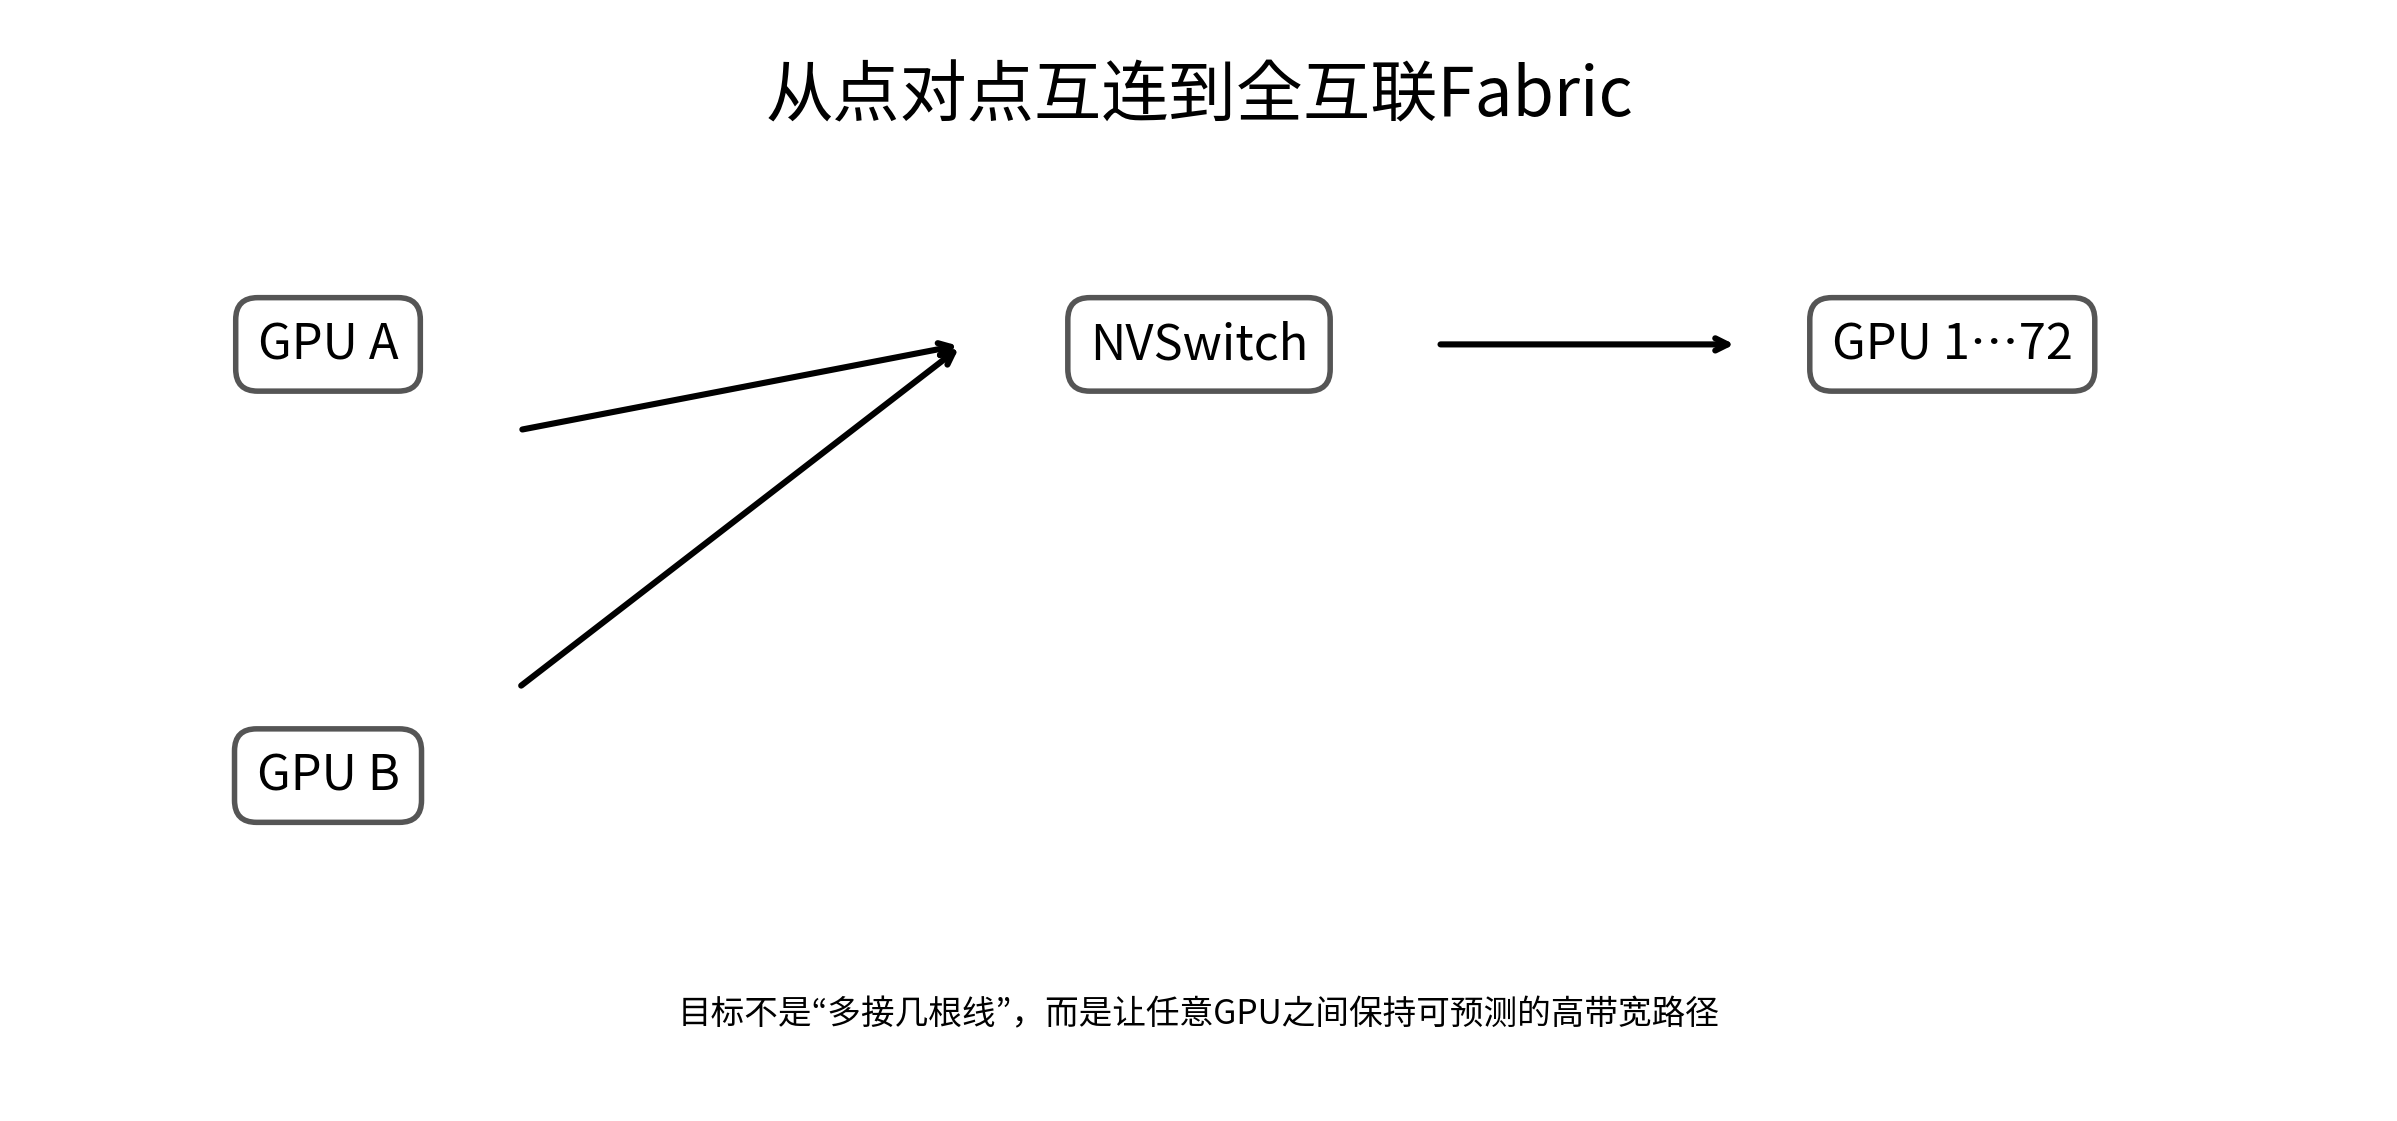
图2|NVSwitch把“GPU之间需要大量互连”转化为“GPU接入统一交换Fabric”。
| 方案 | 优势 | 主要问题 |
| 简单点对点 | 结构直观 | 规模扩大后链路数量、布线和拓扑管理快速复杂化 |
| 分层交换 | 可扩展 | 可能产生层级带宽与跳数差异 |
| NVLink Switch全互联Fabric | 统一通信域、非阻塞目标 | 交换芯片、连接器、板级SI/PI与散热压力显著增加 |
六、第四层:真正重要的不是“交换”,而是“全互联”
72 GPU系统的关键不是存在一个交换芯片,而是交换结构能否让任意GPU之间获得接近一致的通信能力。NVIDIA对Vera Rubin NVL72的描述是72 GPU all-to-all,NVLink Switch负责把NVLink连接扩展到整个机架。citeturn0search1
这对MoE尤其重要。MoE模型会在不同专家之间进行token路由,GPU之间的通信模式并不总是固定的本地邻居通信。当通信关系变得动态时,网络Fabric本身就成为计算系统的一部分。NVIDIA也明确将NVLink 6 Switch用于通信密集型训练、MoE routing和同步型推理。citeturn0search2
七、第五层:带宽只是第一变量,延迟才决定通信效率
如果带宽解决的是“一次能搬多少数据”,延迟解决的则是“一次通信要等多久”。AI计算中大量collective operation可能反复发生,因此即使峰值带宽很高,只要路径、排队、协议处理或交换延迟出现明显增加,GPU计算单元就可能等待数据。
NVIDIA 2026年的公开资料将NVLink 6描述为面向低延迟、确定性通信的Fabric,并强调其相比通用Ethernet替代方案具有更低延迟和更高数据包处理能力。这里应把这些数字理解为NVIDIA针对其平台的技术宣传指标,而不是所有工作负载下的通用结论。citeturn0search0
八、第六层:为什么NVSwitch本身也越来越像一颗“网络GPU”
新一代NVLink Switch已经不只是转发数据。NVIDIA在Rubin平台中引入SHARP等in-network compute能力,让部分collective operation可以在网络内部完成,从而减少数据反复回到GPU计算核心处理的开销。citeturn0search1turn0search2
| 传统思路 | NVLink Switch思路 |
| GPU计算 → 网络传输 → GPU计算 | 网络内部完成部分聚合/归约 |
| 网络只负责搬数据 | 网络开始参与通信计算 |
| 通信与计算相对分离 | 通信Fabric成为计算架构的一部分 |
九、第七层:NVSwitch为什么会把压力传给PCB与连接器?
交换芯片本身再强,也必须通过物理互连把信号送到GPU。于是交换架构会把压力继续传导到高速PCB、背板/中板、连接器、封装、供电和散热。
尤其在高数据率下,插损、回损、串扰、阻抗控制、过孔结构、走线长度差异都会影响信号完整性。也就是说,NVSwitch的性能不是单颗芯片的性能,而是“芯片+封装+连接器+PCB+系统拓扑”的共同结果。
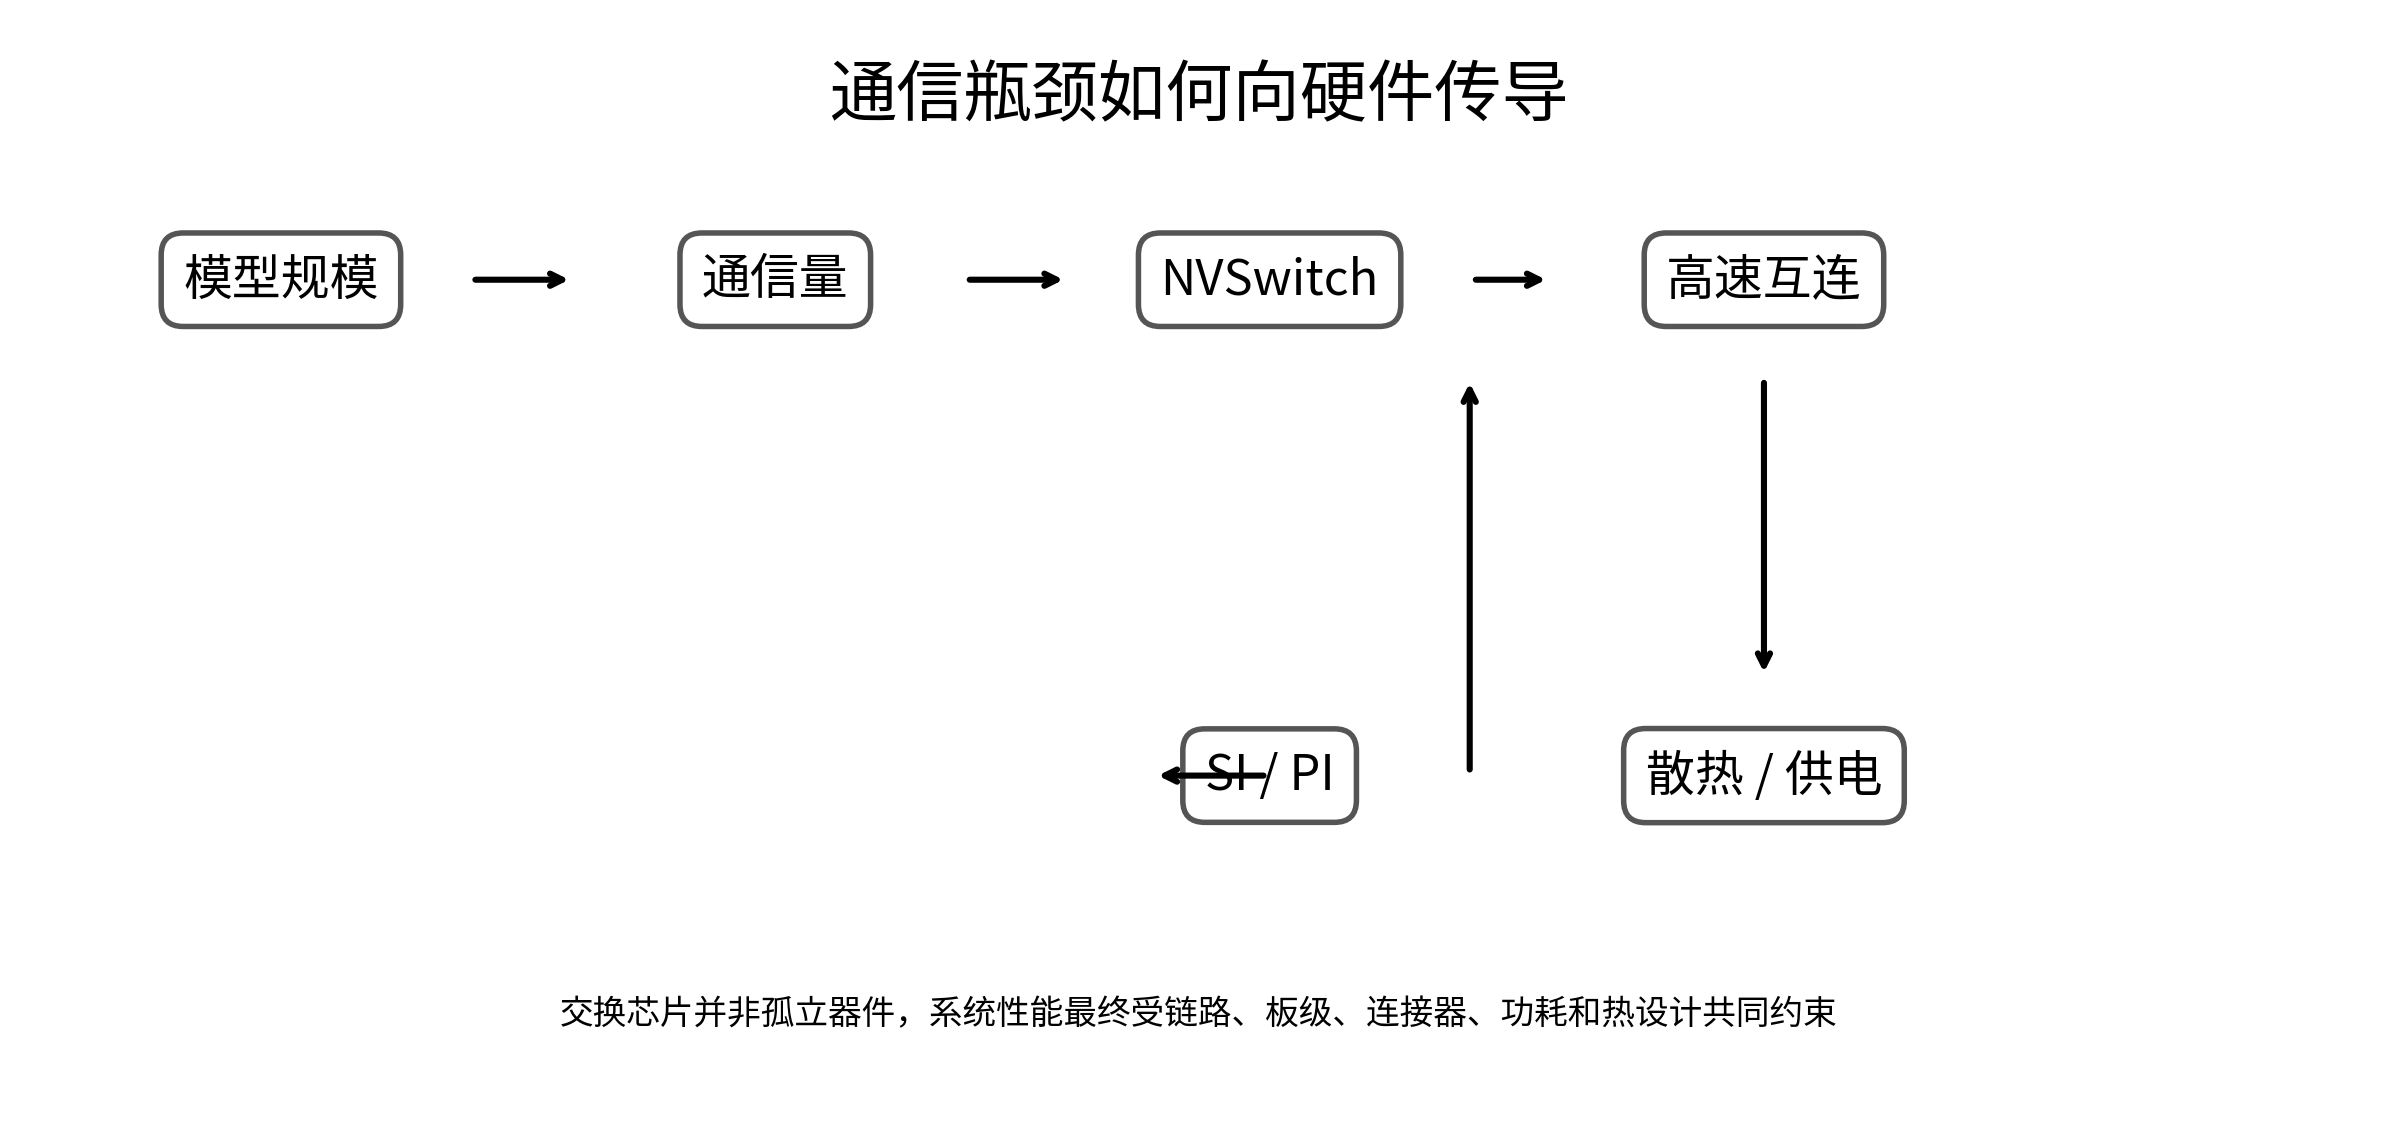
图3|NVSwitch的系统瓶颈会沿高速互连链路继续向PCB、连接器、供电与散热传导。
十、第八层:为什么MoE会进一步提高NVSwitch的价值
MoE把模型拆成多个专家,token会被路由到不同专家。随着专家数量和GPU数量增加,通信模式更容易出现跨GPU的数据交换。此时GPU计算能力增长得越快,通信Fabric如果没有同步升级,就越可能成为系统瓶颈。
所以NVSwitch不是单纯跟随GPU数量增加,而是跟随“模型并行度×通信强度×GPU规模”共同升级。
| 变量 | 上升意味着什么 | 对应硬件压力 |
| GPU数量 | 通信对象增多 | 交换规模/链路规模 |
| 模型并行度 | 跨GPU同步增多 | Fabric带宽与延迟 |
| MoE专家数量 | 动态路由增多 | 交换与流控 |
| Reasoning深度 | 通信轮次可能增加 | 低延迟与稳定性 |
| GPU峰值算力 | 计算速度更快 | 通信必须同步提升 |
十一、第九层:NVSwitch的功耗为什么值得关注
交换芯片本身需要处理大量高速I/O,同时还承担复杂的交换、管理和部分网络内计算。随着SerDes速率、端口数量和交换容量上升,I/O功耗与芯片总功耗都会成为系统设计变量。
因此NVSwitch的升级不会只表现为芯片价格变化,还会同步影响:供电网络、VRM、PCB铜层、连接器、液冷路径以及机架级热预算。
十二、第十层:NVSwitch为什么开始进入“可维护性”设计
对于单块服务器,交换芯片故障影响范围有限;但在72 GPU的统一计算域里,交换Fabric承担的是系统级通信。一处故障可能影响大量GPU之间的通信,因此可靠性成为架构设计的一部分。
NVIDIA公开资料显示,NVLink 6 Switch引入控制平面韧性、部分部署运行、交换Tray热插拔以及动态流量恢复等能力;2026年9月最新公开的NVLink 6韧性资料进一步介绍了链路级纠错、重试、信用流控和故障隔离机制。citeturn0search1turn0search6
十三、把NVSwitch放回NVL72:它到底处于什么位置?
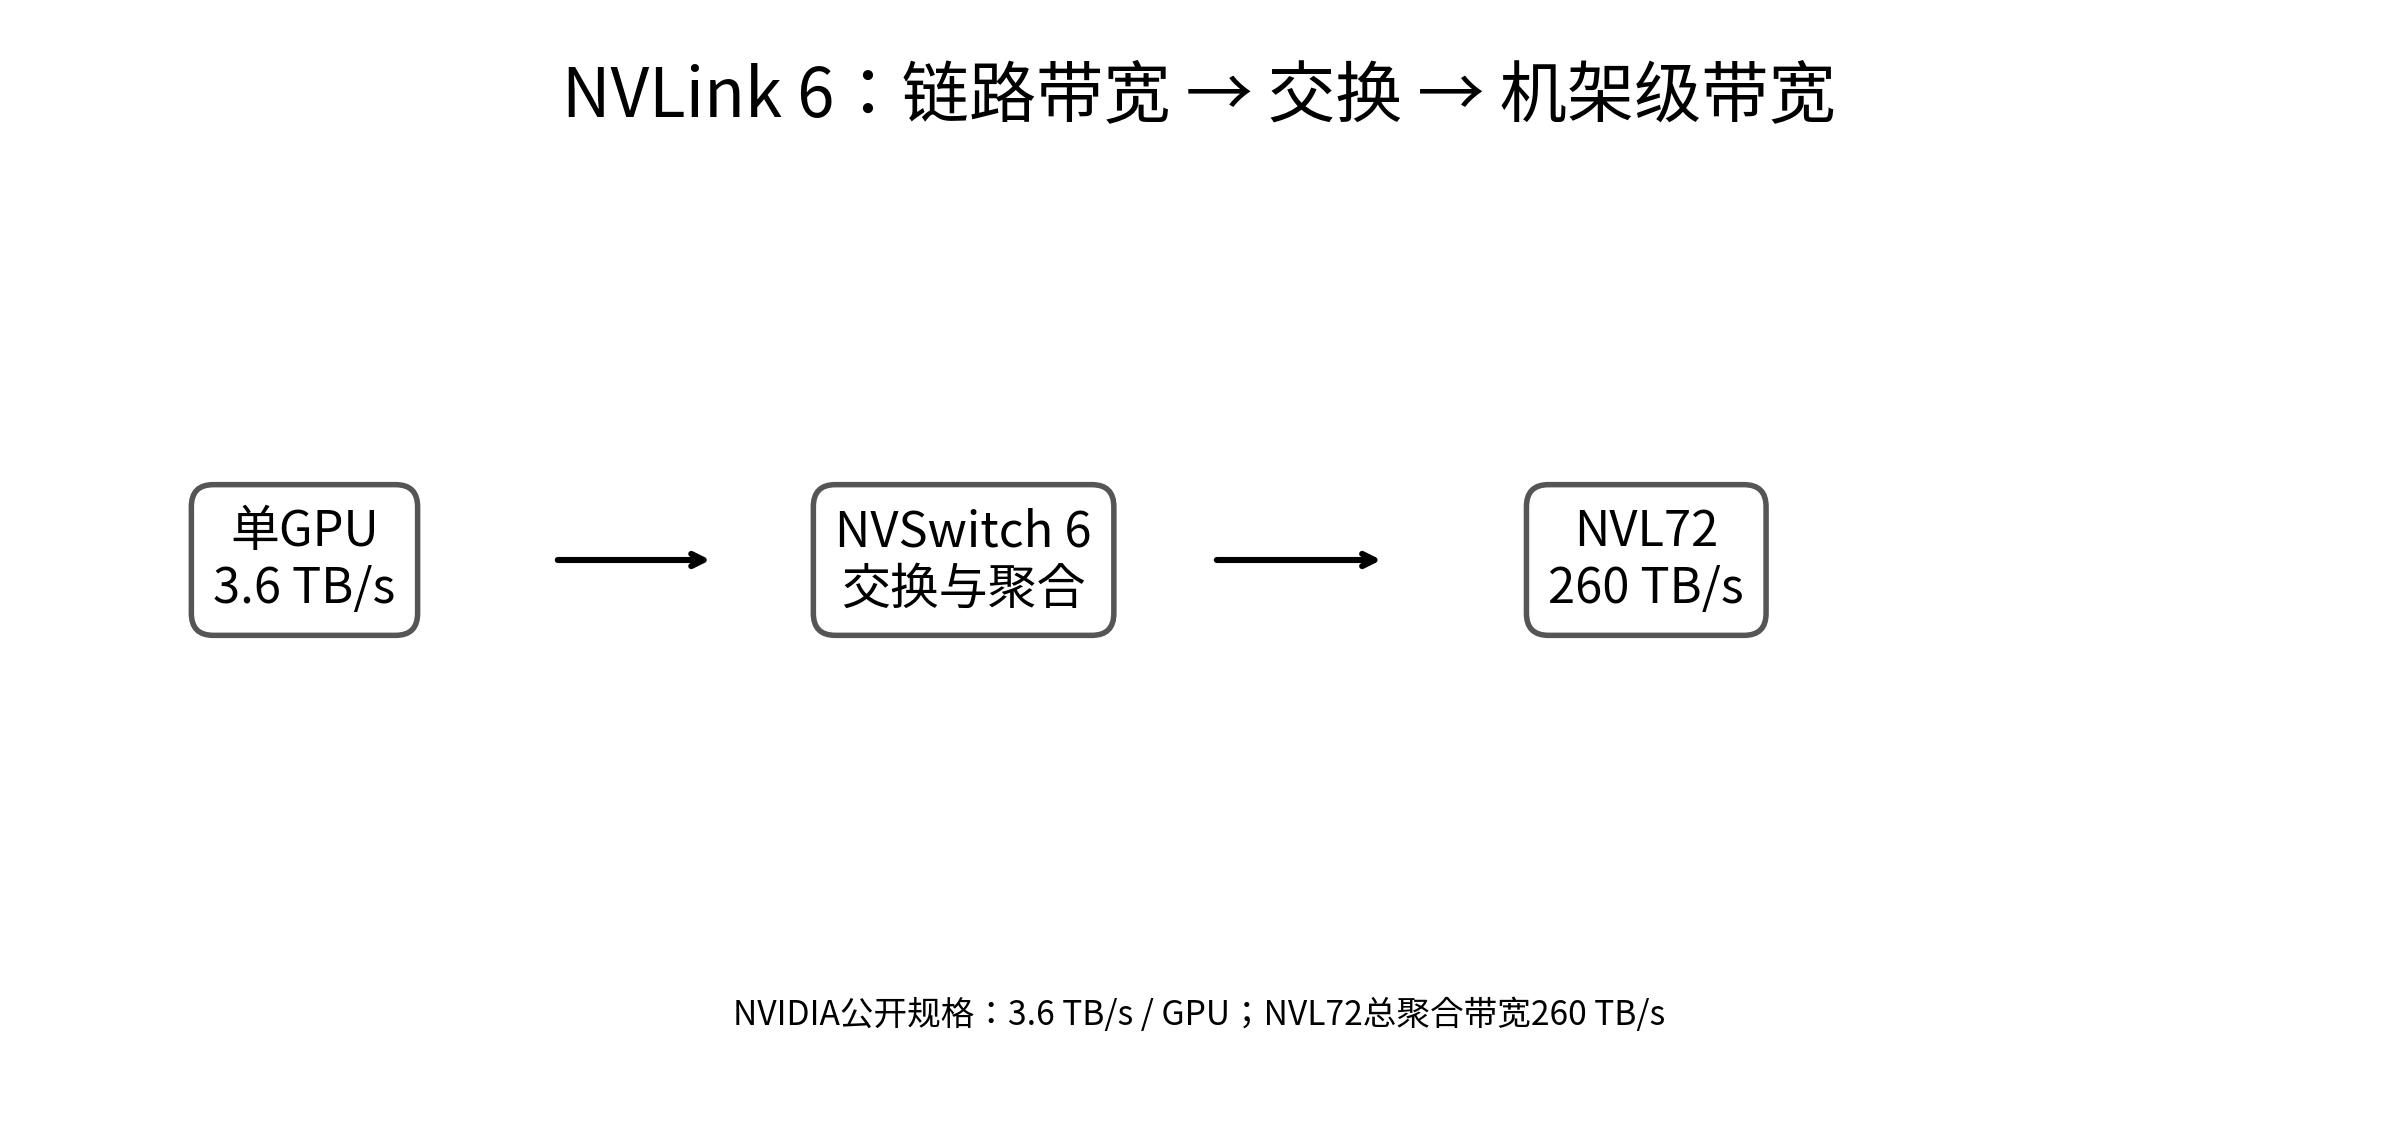
图4|从单GPU链路,到交换Fabric,再到NVL72机架级通信域。
| 层级 | 核心器件 | 解决的问题 |
| GPU | Rubin GPU | 产生计算与通信数据 |
| Link | NVLink 6 | 提供GPU高速互连 |
| Switch | NVLink 6 Switch | 组织、交换、聚合大量NVLink |
| Fabric | NVL72 | 形成72 GPU统一通信域 |
| Scale-out | ConnectX / Ethernet | 连接更大数据中心网络 |
需要特别区分scale-up与scale-out:NVLink/NVSwitch主要解决GPU之间的scale-up通信;ConnectX、Spectrum等则承担更广域的数据中心scale-out。两者不是简单替代关系,而是不同通信层级。
十四、NVSwitch真正的产业价值:不是一颗芯片,而是一整套“高速通信约束”
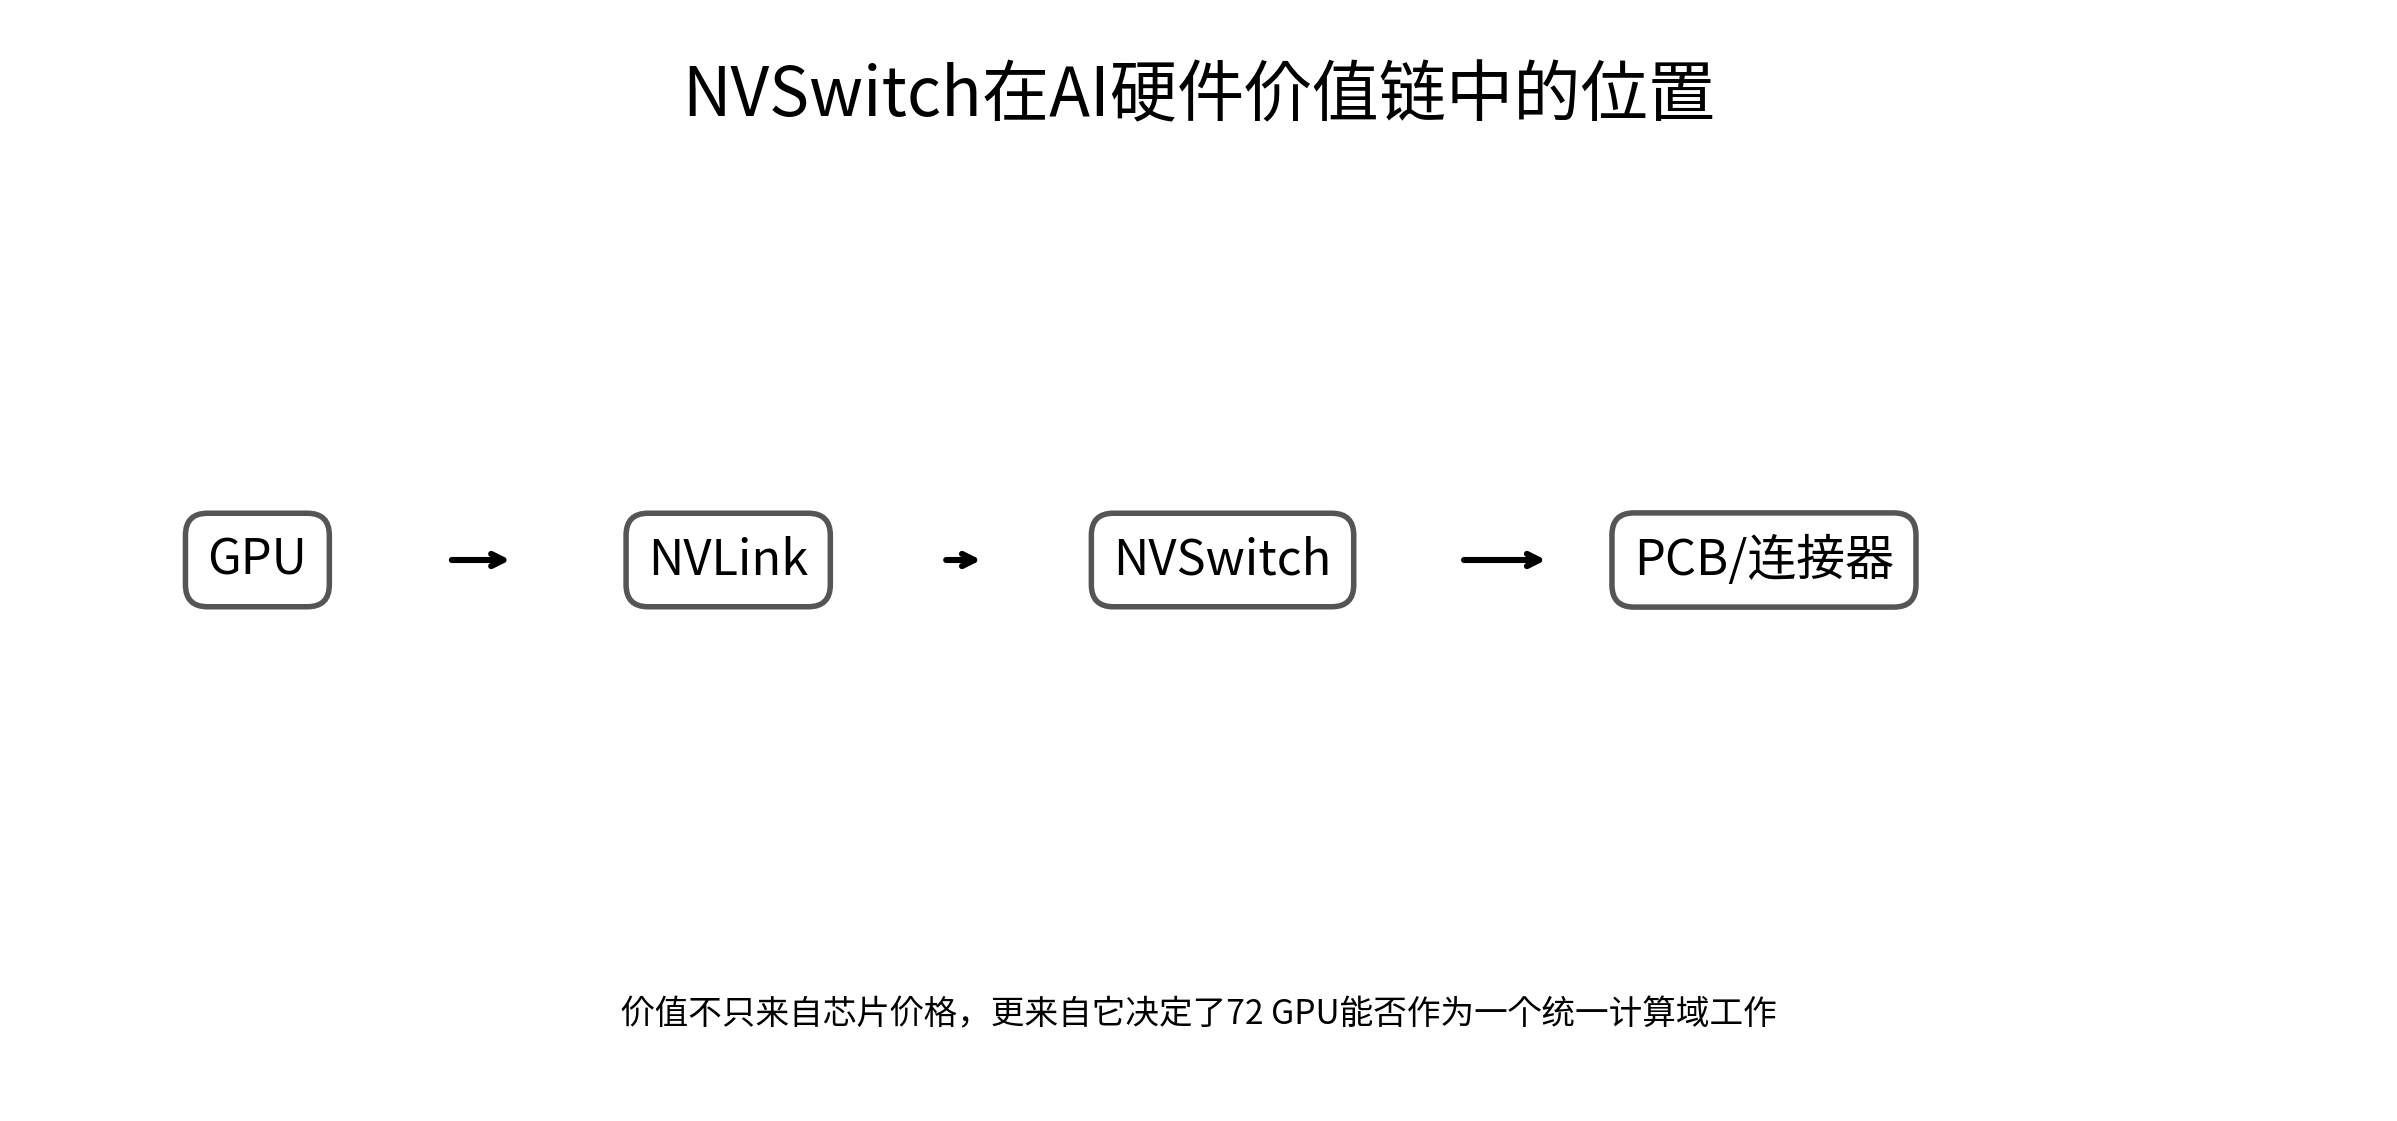
图5|NVSwitch的产业价值沿通信链条向外扩散。
当交换Fabric成为AI系统的核心以后,产业价值自然向高速PCB、连接器、封装、SerDes、信号完整性材料、供电与散热等环节扩散。
| 环节 | 被什么变量驱动 | 产棱关注点 |
| NVSwitch芯片 | GPU规模、带宽、端口数 | 代际升级与交换能力 |
| 高速PCB | 高速I/O数量与速率 | 层数、材料、SI/PI、良率 |
| 连接器 | 高速链路密度 | 插损、串扰、可靠性 |
| 封装 | I/O密度、功耗 | 先进封装与散热 |
| 电源 | 交换芯片+高速I/O功耗 | PDN稳定性 |
| 液冷 | 芯片热密度 | 冷板与系统热路径 |
十五、NVSwitch是不是新的产业瓶颈?
不能简单下结论。真正应该观察的是:某一代GPU升级以后,NVSwitch的需求是否出现了比GPU本身更快的技术复杂度增长,以及这种增长是否进一步造成高端PCB、连接器、封装、供电或散热的有效产能约束。
也就是说,产棱不把“NVSwitch重要”直接等同于“NVSwitch一定成为投资瓶颈”。真正值得进入瓶颈池的是下面这些可验证变量。
| 瓶颈变量 | 验证方式 | 状态变化的意义 |
| GPU通信带宽 | 代际规格 | 是否继续翻倍 |
| Switch端口/交换容量 | 产品规格 | Fabric规模是否扩大 |
| 高速PCB层数/材料 | 供应链/产品变化 | 板级难度是否提升 |
| 连接器速率 | 供应商产品/认证 | 高速互连是否成为约束 |
| SI/PI良率 | 供应链反馈 | 设计复杂度是否转化为有效产能约束 |
| Switch Tray功耗 | 系统规格 | 供电/散热压力是否继续上升 |
| 维护与故障机制 | NVIDIA架构更新 | 系统级可靠性是否成为显性变量 |
十六、一个容易被忽视的变化:AI服务器正在从“服务器”变成“GPU网络”
传统服务器的核心逻辑是CPU、内存、存储和I/O围绕主板组织;NVL72的核心逻辑则越来越接近“GPU计算节点+高速通信Fabric”。GPU之间的通信已经不是附属功能,而是决定整个系统能否有效利用计算资源的重要组成。
因此,AI硬件产业链的观察方式也必须改变:不能只看GPU、HBM、CoWoS,而要继续向“GPU之间如何连接”追踪。NVLink → NVSwitch → 高速PCB/连接器 → 电源/散热,构成另一条越来越重要的价值传导链。
十七、产棱如何持续跟踪NVSwitch
| 观察层 | 每日/每周观察变量 | 触发条件 |
| 产品层 | NVLink/NVSwitch代际规格 | 带宽、端口、拓扑变化 |
| 系统层 | NVL72/NVL更大域 | GPU数量、Switch Tray数量变化 |
| 工程层 | PCB/连接器/封装 | 速率、层数、材料、SI/PI变化 |
| 产业层 | 供应商扩产/认证 | 高端产能变化 |
| 市场层 | 相关产业链资产表现 | 产业状态是否开始反映到资产价格 |
| 证伪层 | 实际部署与客户采用 | 规格是否真正转化为需求 |
十八、NVSwitch价格 ≠ NVSwitch产业价值
交换芯片本身的BOM金额并不能完整代表它创造的价值。它的真正价值在于:如果没有足够强的交换Fabric,72颗高价值GPU可能无法以预期效率协同工作。
因此,对NVSwitch的产业研究不能停留在“芯片多少钱”,而应该继续问三个问题:
- 它是否决定GPU集群的有效计算效率?
- 它是否把新的工程压力传导给PCB、连接器、封装、供电和散热?
- 这些压力是否已经形成真实的供给约束,而不是停留在技术升级层面?
十九、产棱最终拆解:为什么72颗GPU背后必须有一个“交换大脑”
第一,GPU算力增长会同步提高GPU之间的数据交换需求。
第二,NVLink解决单GPU高速互连,但大量GPU需要一个统一的交换结构。
第三,NVSwitch把多条NVLink组织成all-to-all Fabric,使72 GPU能够形成统一计算域。
第四,交换Fabric的升级会继续把压力传导到高速PCB、连接器、封装、供电、散热和可靠性。
第五,因此AI硬件的价值链正在从“GPU本身”继续向“GPU之间如何通信”扩展。
产棱核心判断:**NVSwitch真正重要的地方,不是它是一颗交换芯片,而是它把“GPU网络”变成了AI计算系统的一部分。** 当GPU从单卡计算进入大规模统一计算域,交换Fabric本身就成为系统性能、工程复杂度和产业瓶颈的重要观察窗口。
二十、研究边界与来源
本文中的NVLink 6、NVSwitch、NVL72拓扑及带宽数据,优先采用NVIDIA 2026年公开资料。不同代际NVSwitch的端口数量、Switch Tray配置不能混用;历史NVSwitch资料仅用于解释架构演进。NVIDIA当前公开规格也注明部分规格可能调整,因此后续应以量产平台资料持续校验。citeturn0search1turn0search2
核心来源:NVIDIA NVLink官方规格;NVIDIA Vera Rubin平台技术博客;NVIDIA 2026年NVLink系统级技术文章;NVIDIA NVLink 6韧性技术文章;NVIDIA历史NVSwitch技术概览。